Was ist RAG?
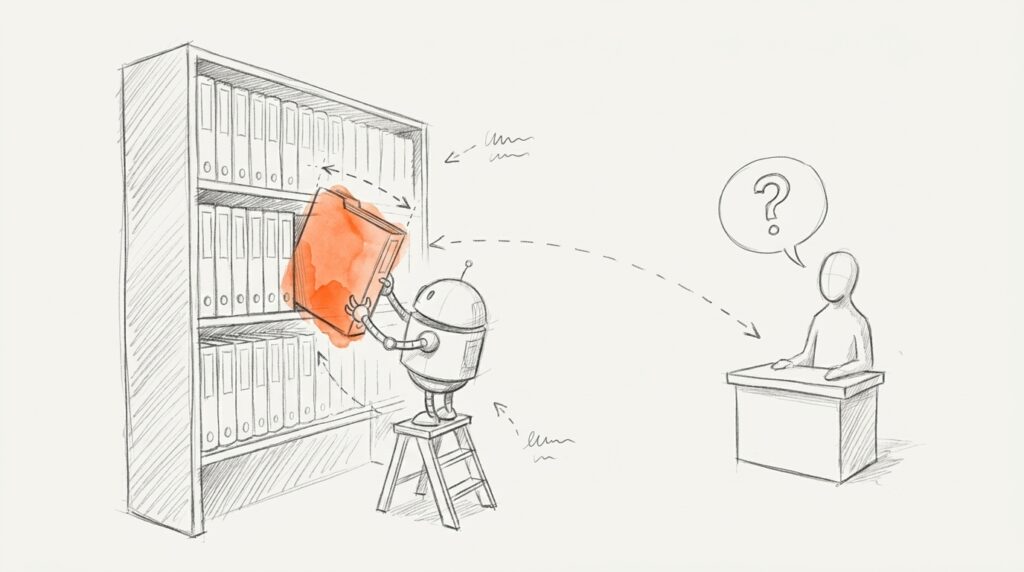
Ein Sprachmodell weiß viel — aber nur, was bis zum Ende seines Trainings im Netz stand. Deine aktuellen Preise, dein Rückgaberecht, dein neues Produkt kennt es nicht. RAG löst das: Die KI schlägt erst nach und antwortet dann.
Ausgeschrieben heißt das Retrieval-Augmented Generation, auf Deutsch etwa „abrufgestützte Generierung“. NVIDIA erklärt es mit einem schönen Bild: Ein Richter kennt das Recht im Allgemeinen. Für einen Spezialfall schickt er aber jemanden in die Bibliothek, der die passenden Urteile holt.
Der Begriff stammt aus einem Paper von 2020 von Forschern bei Facebook AI Research (heute Meta), dem University College London und der New York University.
Wie funktioniert RAG?
AWS beschreibt den Ablauf in vier Schritten:
- Vorbereiten — deine Dokumente werden in kleine Stücke zerlegt (Chunking) und als Zahlenvektoren gespeichert, sogenannte Embeddings, meist in einer Vektor-Datenbank.
- Suchen — die Frage des Nutzers wird ebenfalls in einen Vektor verwandelt, und das System sucht die ähnlichsten Textstücke.
- Anreichern — die Treffer landen zusammen mit der Frage im Prompt.
- Aktuell halten — neue oder geänderte Dokumente werden laufend nachgepflegt.
Dass das Wissen austauschbar ist, zeigt schon das Original-Paper: Mit einem Wikipedia-Stand von 2016 beantwortete das System Fragen nach den Staats- und Regierungschefs von 2016 zu 70 % richtig, mit dem Stand von 2018 die von 2018 zu 68 %. Vertauschte man die Stände, fiel die Quote auf 4 bis 12 %. Neues Wissen braucht kein neues Training — nur neue Unterlagen.
RAG, Fine-Tuning oder einfach alles in den Prompt?
Weg
Passt für
Alles in den Prompt
Wenig Wissen, bis rund 500 Seiten
RAG
Viel Wissen, das sich oft ändert
Fine-Tuning
Stil, Format, Verhalten
Anthropic schreibt: Ist deine Wissensbasis kleiner als rund 200.000 Tokens, also etwa 500 Seiten, kannst du sie oft einfach komplett in den Prompt geben. Dafür reicht das Kontextfenster heutiger Modelle. Ein Haken bleibt: Laut der Studie „Lost in the Middle“ von 2023 nutzen Modelle Informationen am Anfang und Ende langer Texte deutlich besser als in der Mitte.
Fine-Tuning trainiert das Modell mit eigenen Daten nach. Für neue Fakten taugt das schlecht: In einer Vergleichsstudie von 2023/24 schnitt RAG beim Aufnehmen von Wissen durchweg besser ab als unüberwachtes Fine-Tuning.
Beispiele aus der Praxis
Zwei Einsätze im Kundenservice, beide von den Unternehmen selbst veröffentlicht.
Case A · Kundenservice
LinkedIn, Support mit alten Tickets
+77,6 %
Trefferqualität
−28,6 %
Lösungszeit je Anliegen
Gemessen nach rund sechs Monaten im Service-Team
RAG über frühere Support-Tickets, verknüpft als Wissensgraph (Fachartikel, April 2024).
Case B · Fahrer-Hotline
DoorDash, Antworten aus der Hilfe-Seite
≤ 2,5 s
Antwortzeit
8 Wochen
Bauzeit
Tausende Eskalationen an Menschen weniger pro Tag
Fallstudie von AWS (Anbieter), gebaut mit Amazon Bedrock und Claude 3 Haiku, getestet Anfang 2024.
Häufige Fehler
Fehler 1 · Glauben, RAG beendet Halluzinationen
Tut es nicht. Eine Stanford-Studie von 2024 testete juristische Recherche-Tools, die auf RAG setzen: Sie erfanden trotzdem in 17 bis 33 % der Fälle etwas. Besser als ein normaler Chatbot, aber weit weg von fehlerfrei. Lass Antworten mit Quellenangabe ausgeben und prüf sie.
Fehler 2 · Alte oder schlechte Unterlagen
Die KI gibt wieder, was sie findet. Steht in deinem Wissensordner die Preisliste von 2023, nennt der Chatbot die Preise von 2023. Mülleimer rein, Mülleimer raus — die Pflege der Wissensbasis ist der eigentliche Job.
Fehler 3 · Textstücke ohne Zusammenhang
„Der Umsatz stieg um 3 %“ — von wem, wann? Ein Schnipsel ohne Kontext wird falsch oder gar nicht gefunden. Anthropic hat gemessen, dass ein kurzer Kontext-Vorsatz je Stück plus Stichwortsuche und Nachsortieren die Fehlerquote beim Abruf um 67 % senkt (Herstellertest, 2024).
Fehler 4 · RAG bauen, wo es keins braucht
Drei PDFs und eine FAQ-Seite brauchen keine Vektor-Datenbank. Lad sie in ein Claude-Projekt oder einen Custom GPT, fertig. Ein eigenes System lohnt sich erst bei großen oder ständig wechselnden Beständen.
Wann lohnt sich RAG für dich?
- Support-Chatbot — beantwortet Fragen aus Hilfe-Seiten, AGB und Handbüchern.
- Produktberatung — kennt Sortiment, Maße und Verfügbarkeit.
- Internes Wissen — Vorlagen, Styleguide und Projekt-Doku für das eigene Team.
- Content-Produktion — Texte, die sich auf deine eigenen Studien und Fälle stützen.
Bauen kannst du das ohne Code mit Claude Projects, ChatGPT Custom GPTs oder OpenAI File Search. Mit etwas Technik geht es über n8n, LangChain oder LlamaIndex und Vektor-Datenbanken wie Pinecone, Qdrant oder pgvector.
Häufige Fragen
Was ist der Unterschied zwischen RAG und Fine-Tuning?
Bei RAG bleibt das Modell unverändert und holt sich Wissen bei jeder Frage aus deinen Unterlagen. Beim Fine-Tuning wird es mit eigenen Daten nachtrainiert. Für Fakten, die sich ändern, ist RAG fast immer der bessere Weg, Fine-Tuning eher für Stil und Format.
Verhindert RAG Halluzinationen komplett?
Nein. Es senkt sie, weil die Antwort auf Quellen beruht. Studien mit spezialisierten RAG-Tools zeigen aber weiterhin Fehler in einem guten Teil der Antworten. Quellenangaben und Stichproben bleiben Pflicht.
Brauche ich für RAG eine Vektor-Datenbank?
Für ein eigenes System meist ja. Fertige Lösungen wie Claude Projects, Custom GPTs oder OpenAI File Search erledigen das Speichern und Suchen aber selbst. Für kleine Wissensbestände reicht es oft, alles direkt in den Prompt zu geben.
Arbeiten Perplexity und Google AI Overviews mit RAG?
Sie folgen demselben Prinzip: erst im Web suchen, dann mit Quellen antworten. Die Anbieter nennen es selbst nicht RAG, die Idee ist aber dieselbe.
Woher kommt der Begriff RAG?
Aus einem Fachartikel von 2020 von Patrick Lewis und Kollegen bei Facebook AI Research, dem University College London und der New York University. Lewis sagte später, mit Blick auf die Verbreitung hätten sie sich beim Namen mehr Mühe gegeben.
Quellen
- AWS: Was ist Retrieval-Augmented Generation?
- Lewis et al.: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- Anthropic: Contextual Retrieval
- Magesh et al.: Hallucination-Free? Assessing Legal AI Research Tools
- Liu et al.: Lost in the Middle
- Google Search Central: KI-Funktionen und deine Website


