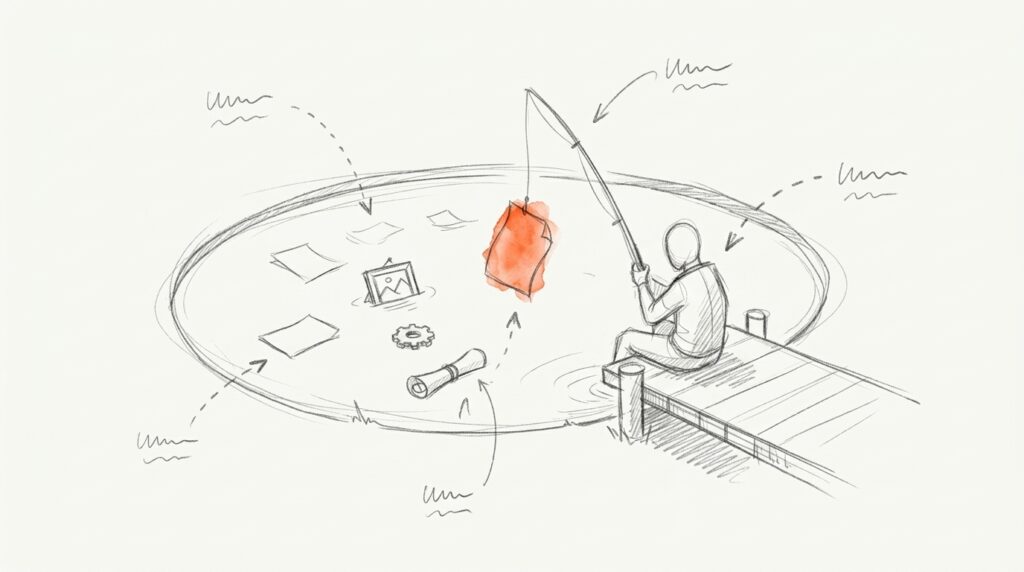
Was ist ein Data Lake?
Wohin mit Kundenfotos, Anruf-Mitschnitten, Server-Logs und zehn Jahren Exporten? In eine ordentliche Tabelle passen sie nicht. Ein Data Lake nimmt sie trotzdem an, und zwar so, wie sie sind.
Amazon beschreibt ihn als zentralen Ort für strukturierte und unstrukturierte Daten in beliebiger Größe, die du vorher nicht strukturieren musst. Microsoft spricht vom nativen Rohformat. Umgeformt wird erst, wenn jemand die Daten braucht.
Das Bild stammt von James Dixon, damals beim Softwarehersteller Pentaho. Er verglich 2010 eine fertige Auswertungstabelle mit Wasser in Flaschen: gereinigt, abgefüllt, beschriftet. Der Data Lake ist dagegen das Gewässer selbst. Du kannst eintauchen oder eine Probe nehmen.
Data Lake oder Data Warehouse?
Der Kern ist der Zeitpunkt der Ordnung. Im Warehouse steht die Struktur fest, bevor Daten hineinkommen. Im Lake entsteht sie beim Lesen. Fachleute sagen Schema-on-write und Schema-on-read.
Data Warehouse
Data Lake
geordnete Tabellen
Rohdaten jeder Art
Struktur beim Laden
Struktur beim Lesen
schnell bei Berichten
langsamer beim Abfragen
teurer Speicher
günstiger Speicher
für Berichte
für Erkundung und KI
Daneben gibt es das Lakehouse. Es verbindet günstigen Speicher mit der Ordnung und Verlässlichkeit eines Warehouse. Databricks hat den Begriff stark geprägt, Google spricht vom „open lakehouse“. Möglich machen das offene Formate: Parquet für die Dateien, Iceberg oder Delta Lake für die Verwaltung darüber.
Ordnung in drei Schichten
Damit der See sauber bleibt, arbeiten viele Teams mit der Medallion-Architektur. Die Daten wandern durch drei Stufen:
- Bronze: roh und ungeprüft, genau wie geliefert.
- Silber: geprüft, bereinigt und ergänzt.
- Gold: verdichtet und fertig für Berichte.
Fehlt diese Ordnung, entsteht ein Data Swamp. Amazon warnt: Ohne Katalog und Absicherung sind Daten weder auffindbar noch vertrauenswürdig. Dann liegt alles im See, und niemand findet etwas wieder. Ein Cloud-Ordner voller Exporte ist übrigens noch kein Data Lake. Ihm fehlen Katalog, Rechte und Löschregeln.
Was kostet ein Data Lake?
Der Speicher selbst ist billig. Das sind die Listenpreise je GB und Monat an deutschen Standorten, Stand November 2026, ohne Zugriffe:
Speicher
Standard je GB/Monat
Amazon S3
0,0245 US-Dollar
Google Cloud
0,023 US-Dollar
Azure
0,0176 Euro
OneLake
0,0215 Euro
Ein Rechenbeispiel: 100 GB Exporte, Bilder und Protokolle kosten bei Amazon in Frankfurt rund 2,45 US-Dollar im Monat. Ein ganzes Terabyte liegt bei 24,50 US-Dollar, im Archiv von Google bei 2,50 US-Dollar plus Abruf.
Teuer wird etwas anderes: Einrichtung, Katalog, Zugriffsrechte, Abfragen und vor allem die Pflege. Wer nur den Speicherpreis rechnet, rechnet sich den See schön.
Häufige Fehler
Fehler 1 · Alles sammeln, ohne Zweck
„Erst mal speichern“ reibt sich mit der DSGVO, sobald Personen dahinterstehen. Sie verlangt einen festgelegten Zweck, wenig Daten und eine begrenzte Speicherdauer. Das ist eine Einordnung und keine Rechtsberatung.
Fehler 2 · Gelöscht glauben
Viele Systeme halten alte Dateiversionen vor. Bei Google Cloud Storage bleiben gelöschte Dateien standardmäßig 7 Tage erhalten. Bei Delta-Tabellen liegen gelöschte Datensätze weiter in den Dateien, bis jemand aufräumt. Wer eine Löschanfrage erfüllt, muss durch alle Schichten.
Fehler 3 · Einen See kaufen, wenn du Berichte brauchst
Fürs Monatsreporting ist ein Data Warehouse schneller, einfacher und meist auch billiger.
Fehler 4 · Keinen Verantwortlichen haben
Ohne jemanden, der Quellen dokumentiert und Rechte vergibt, kippt jeder See. Das gehört zur Data Governance und lässt sich nicht nachkaufen.
Braucht dein Unternehmen einen Data Lake?
Im Marketing meistens nicht. Analytics, Search Console, Anzeigen und CRM liefern Tabellen, und die passen direkt in ein Data Warehouse. In Deutschland wertet laut Eurostat ohnehin erst gut ein Drittel der Unternehmen ab 10 Beschäftigten überhaupt Daten aus. Bei Betrieben mit 10 bis 49 Leuten sind es 32 %.
Sinnvoll wird der See in diesen Fällen:
- Du hast viele Bilder, Videos, Tonaufnahmen oder PDFs, die du auswerten willst.
- Du sammelst Server-Logs oder Sensordaten.
- Du trainierst eigene KI-Modelle.
- Deine Datenmengen sprengen jedes Warehouse-Budget.
Als Speicher kommen dann Amazon S3, Google Cloud Storage oder Azure Data Lake Storage infrage. Als Plattform darüber dienen Databricks, Microsoft Fabric oder Snowflake.
Häufige Fragen
Was ist ein Data Swamp?
Ein Data Swamp ist ein Data Lake ohne Ordnung. Die Daten liegen zwar da, aber ohne Katalog, Beschreibung und Rechte findet oder versteht sie niemand. Deshalb gehören Regeln vor den ersten Upload.
Was ist ein Data Lakehouse?
Ein Lakehouse verbindet den günstigen, offenen Speicher eines Data Lake mit der Ordnung eines Data Warehouse. Du kannst also Rohdaten ablegen und trotzdem verlässliche Berichte darauf bauen.
Wie viel kostet ein Data Lake für kleine Firmen?
Der reine Speicher kostet bei 100 GB rund 2 bis 3 Euro oder Dollar im Monat. Dazu kommen Zugriffe, Abfragen und vor allem Arbeitszeit. Die Pflege ist fast immer der größte Posten.
Wie lösche ich personenbezogene Daten aus einem Data Lake?
In allen Schichten und bei der Quelle. Databricks empfiehlt, in der Bronze-Schicht zu beginnen und die Löschung bis Gold weiterzureichen. Danach müssen auch alte Dateiversionen entfernt werden.
Ist Google Drive ein Data Lake?
Nein. Drive ist eine Dateiablage. Ein Data Lake hat zusätzlich einen Katalog, Zugriffsregeln und Werkzeuge, die große Datenmengen direkt abfragen können.
Quellen
- James Dixon: Pentaho, Hadoop, and Data Lakes (2010)
- AWS: Was ist ein Data Lake?
- Microsoft Learn: Was ist ein Data Lake?
- Google Cloud: Was ist ein Data Lake?
- Databricks: Medallion-Architektur
- AWS: Preise für Amazon S3
- Google Cloud: Preise für Cloud Storage
- Microsoft Azure: Blob-Speicher-Preise
- Databricks: DSGVO-Löschung mit Delta Lake
- DSGVO (Verordnung 2016/679)
- Eurostat: Datenanalyse in Unternehmen 2025