Was ist die robots.txt?
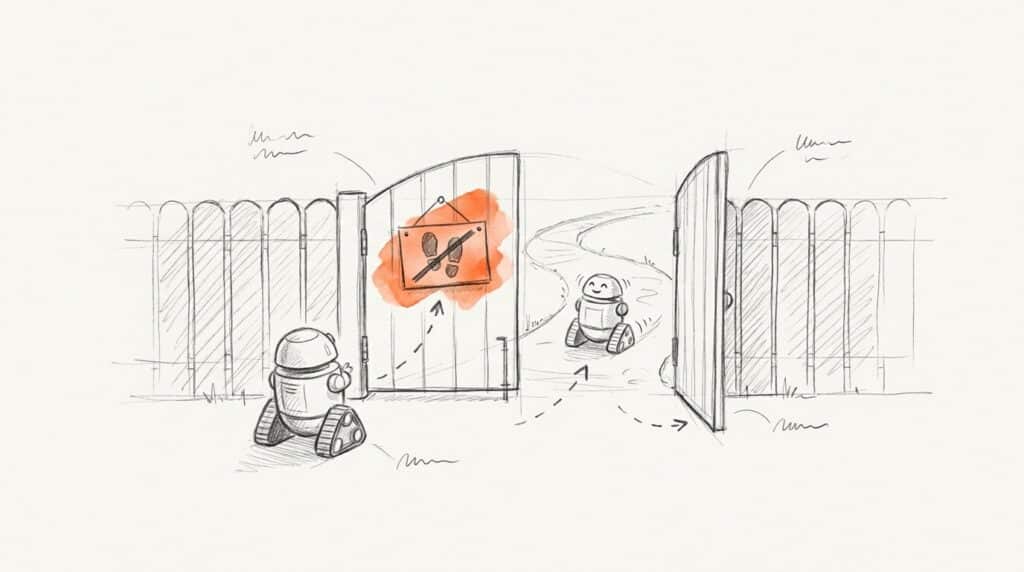
Stell dir ein Schild am Gartentor vor: „Bitte nicht den Rasen betreten.“ Die meisten Besucher halten sich dran. Abschließen tut das Schild aber nichts. Genau so funktioniert die robots.txt.
Sie ist eine einfache Textdatei, die immer unter „deine-domain.de/robots.txt“ liegt. Darin steht, welche Crawler — die Programme, mit denen Suchmaschinen und KI-Anbieter Websites abrufen — welche Bereiche besuchen dürfen. Seit 2022 ist das Verfahren als Robots Exclusion Protocol ein offizieller Internet-Standard (RFC 9309).
Laut Google dient die Datei vor allem dazu, die Last durch Crawler auf deinem Server zu steuern. Jede Subdomain braucht ihre eigene Datei, und sie muss im Hauptverzeichnis liegen — in einem Unterordner gilt sie nicht.
Wie ist die Datei aufgebaut?
Google versteht vier Anweisungen:
Anweisung
Bedeutung
user-agent
Für welchen Crawler
disallow
Pfad nicht abrufen
allow
Ausnahme davon
sitemap
Wo die Sitemap liegt
Passen mehrere Regeln, gewinnt bei Google die längste, also genaueste. Pfade unterscheiden Groß- und Kleinschreibung: „/Blog/“ ist nicht „/blog/“. Google liest höchstens 500 KiB der Datei und speichert sie in der Regel bis zu 24 Stunden zwischen — Änderungen wirken also nicht sofort.
Die Anweisung „crawl-delay“ ignoriert Google, andere Crawler wie der von Anthropic beachten sie. Und „noindex“ in der robots.txt wertet Google seit September 2019 nicht mehr aus.
robots.txt und KI-Crawler
Seit es Sprachmodelle gibt, ist die Datei wieder spannend. Die großen Anbieter trennen ihre Crawler nach Zweck — und das solltest du kennen:
- OpenAI: GPTBot sammelt Trainingsdaten, OAI-SearchBot entscheidet über die Sichtbarkeit in der ChatGPT-Suche. Wer nur GPTBot sperrt, bleibt in der ChatGPT-Suche sichtbar.
- Anthropic: ClaudeBot fürs Training, Claude-SearchBot für die Suche.
- Google: Google-Extended steuert das Training von Gemini. Laut Google hat die Sperre keinen Einfluss auf die Aufnahme in die Google-Suche und ist kein Rankingsignal.
Aber: Ruft ein KI-Assistent eine Seite auf, weil ein Nutzer ausdrücklich danach fragt, gilt die robots.txt laut OpenAI womöglich nicht. Eine zuverlässige Sperre gegen jede KI ist sie also nicht.
Wie das Web es nutzt
Case A · Nachrichtenseiten
Sperre von KI-Crawlern, Ende 2023
60 %
in Deutschland
48 %
international (OpenAI)
Deutsche Verlage sperren überdurchschnittlich oft
Reuters Institute, 150 meistgenutzte Nachrichtenseiten in zehn Ländern. In Deutschland sperrten 60 % OpenAI und Google-Extended.
Case B · Alle Websites
GPTBot in der robots.txt genannt
2,9 %
2024
4,5 %
2025
Steigend, aber die große Mehrheit regelt nichts
HTTP Archive Web Almanac, Desktop-Seiten. Gezählt wird, ob der Crawler genannt wird — nicht, ob er gesperrt ist.
Häufige Fehler
Fehler 1 · Disallow statt noindex
Der Klassiker. Du willst eine Seite aus Google haben, sperrst sie per robots.txt — und setzt zusätzlich noindex. Ergebnis: Google darf die Seite nicht abrufen, sieht das noindex nie, und die URL bleibt im Index. Für noindex muss die Seite crawlbar sein.
Fehler 2 · „Disallow: /“ vom Testsystem übernommen
Auf der Testumgebung sperrt diese eine Zeile zu Recht alles. Wird die Datei beim Livegang mitkopiert, ist plötzlich die ganze Website für Crawler dicht. Nach jedem Relaunch als Erstes prüfen.
Fehler 3 · CSS und JavaScript sperren
Ohne diese Dateien sieht Google deine Seite wie einen Rohbau. Google rät davon ab, sie zu sperren, wenn die Seite dadurch schwerer zu verstehen ist.
Fehler 4 · Die Datei als Geheimhaltung nutzen
Die robots.txt ist öffentlich. Wer dort „/interne-preisliste/“ sperrt, verrät erst recht, wo es etwas zu sehen gibt. Vertrauliches gehört hinter ein Passwort.
So prüfst und pflegst du sie
WordPress liefert ohne eigene Datei automatisch eine virtuelle robots.txt aus, die den Admin-Bereich sperrt. Bearbeiten kannst du sie zum Beispiel in Yoast SEO unter Werkzeuge → Datei-Editor. In der Google Search Console zeigt der Bericht „robots.txt“, welche Version Google abgerufen hat und ob es Fehler gab; dort kannst du auch einen neuen Abruf anfordern.
Häufige Fragen
Entfernt Disallow eine Seite aus Google?
Nein. Disallow verhindert nur das Abrufen. Die URL kann trotzdem im Index landen, etwa über Links von anderen Seiten. Zum Entfernen brauchst du noindex — und die Seite darf dafür nicht gesperrt sein.
Wo muss die robots.txt liegen?
Im Hauptverzeichnis der Domain, also unter /robots.txt, in Kleinbuchstaben. Jede Subdomain braucht eine eigene Datei. In einem Unterordner wird sie ignoriert.
Wie sperre ich KI-Crawler?
Mit einem eigenen user-agent-Block je Crawler, etwa für GPTBot, ClaudeBot oder Google-Extended. Die Such-Crawler der Anbieter laufen getrennt — wer nur die Trainings-Crawler sperrt, bleibt in der KI-Suche sichtbar.
Schadet es meinem Google-Ranking, wenn ich Google-Extended sperre?
Laut Google nein. Google-Extended steuert nur das Training und Grounding von Gemini und hat keinen Einfluss auf die Google-Suche.
Brauche ich überhaupt eine robots.txt?
Nicht zwingend. Fehlt sie, crawlt Google einfach alles. WordPress liefert ohnehin eine virtuelle Datei aus. Eine eigene lohnt sich, wenn du Bereiche ausschließen oder KI-Crawler regeln willst.
Quellen
- IETF: RFC 9309 Robots Exclusion Protocol
- Google Search Central: Einführung in robots.txt
- Google Search Central: So interpretiert Google robots.txt
- Google Search Central: Indexierung mit noindex blockieren
- OpenAI: Übersicht der Crawler
- Anthropic: Crawler und robots.txt
- Google Search Central: Google-Crawler
- Reuters Institute: How many news websites block AI crawlers?
- HTTP Archive: Web Almanac 2025, SEO