

Was ist Constitutional AI?
Ein Sprachmodell muss lernen, was es sagen soll und was nicht. Der übliche Weg: Menschen lesen zwei Antworten und klicken die bessere an. Das kostet viel Zeit, und bei schädlichen Inhalten müssen Menschen sich durch genau das Material wühlen, das niemand sehen will.
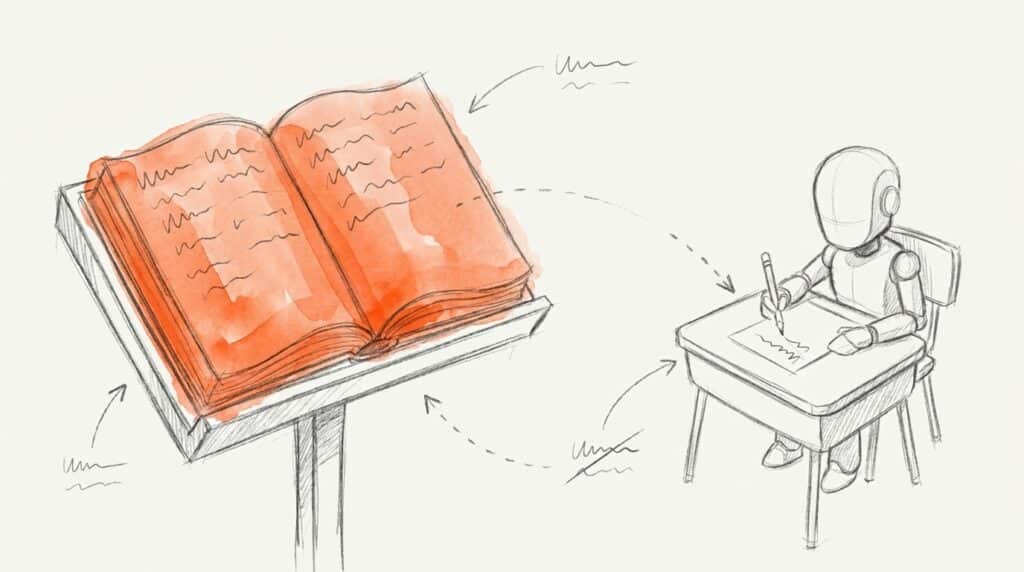
Constitutional AI dreht das um. Statt tausender Einzelurteile schreibt der Hersteller einmal auf, welche Prinzipien gelten — die Verfassung. Dann bewertet eine KI die Antworten gegen diese Liste. Anthropic hat die Methode im Dezember 2022 in einem Paper vorgestellt und trainiert damit seine Claude-Modelle.
Das Training läuft in zwei Phasen:
- Selbstkritik: Das Modell schreibt eine Antwort, prüft sie gegen ein Prinzip der Verfassung und überarbeitet sie. Aus den verbesserten Antworten lernt es.
- KI-Feedback: Eine KI vergleicht jeweils zwei Antworten und wählt nach den Prinzipien die weniger schädliche aus. Mit diesen Urteilen wird das Modell weiter trainiert. Fachleute nennen das RLAIF, verstärkendes Lernen mit KI-Feedback.
Was steht in der Verfassung?
Im ersten Paper reichten 16 Prinzipien. 2023 veröffentlichte Anthropic eine längere Fassung mit rund 58 Prinzipien. Die Quellen waren bunt gemischt:
- die Allgemeine Erklärung der Menschenrechte der Vereinten Nationen
- Nutzungsbedingungen großer Plattformen, etwa von Apple
- Regeln aus der Forschung anderer KI-Labore
- Prinzipien, die nicht-westliche Sichtweisen berücksichtigen sollen
Im Januar 2026 kam eine neue, deutlich längere Verfassung. Sie setzt weniger auf Einzelregeln und mehr auf begründete Werte und Urteilskraft. Die Rangfolge: erst breit sicher, dann ethisch, dann Anthropics Richtlinien folgen, dann wirklich hilfreich sein. Anthropic betont, dass es eine Gesamtabwägung ist, keine starre Reihenfolge. Der Text steht unter der freien Lizenz CC0 — jeder darf ihn nutzen.
Was die Methode gebracht hat
Im Originalversuch lief das Training mit einem Modell mit 52 Milliarden Parametern und rund 183.000 Testfragen aus dem Red Teaming, also gezielten Angriffsversuchen. Das Ergebnis: Das Modell war harmloser als die Variante mit reinem Menschen-Feedback — und wich heiklen Fragen trotzdem kaum noch aus. Das ältere Verfahren hatte oft einfach abgeblockt.
Fall A · Schutz vor Jailbreaks
Constitutional Classifiers (Anthropic, 2025)
86 % → 4,4 %
erfolgreiche Jailbreaks
+23,7 %
Rechenaufwand
Ein Filtersystem, das ebenfalls aus einer Verfassung lernt, blockte im Test fast alle Angriffe.
Herstellerangabe mit synthetischen Jailbreaks. Harmlose Anfragen wurden kaum häufiger abgelehnt (+0,38 Prozentpunkte).
Fall B · Verfassung vom Publikum
Collective Constitutional AI (2023)
rund 1.000
beteiligte US-Bürger
38.252
abgegebene Stimmen
Die Bürger-Verfassung deckte sich nur etwa zur Hälfte mit Anthropics eigener.
Das damit trainierte Modell zeigte in allen neun gemessenen Bereichen weniger Vorurteile bei gleicher Leistung.
Häufige Fehler
Fehler 1 · „Da hat kein Mensch mehr mitgewirkt“
Falsch. Ohne menschliche Bewertungen lief nur der Teil zur Harmlosigkeit. Für die Hilfsbereitschaft nutzte das Paper weiterhin rund 135.000 Vergleiche von Menschen. Und die Verfassung selbst schreiben natürlich auch Menschen.
Fehler 2 · Verfassung mit Garantie verwechseln
Eine Verfassung beschreibt, wie sich das Modell verhalten soll. Anthropic schreibt selbst, dass Claude den Idealen nicht immer entspricht. Halluzinationen und Fehler gibt es weiter. Prüf Ergebnisse, bevor sie rausgehen.
Fehler 3 · Glauben, man könne sie per Prompt umschreiben
Mit einem System-Prompt steuerst du Ton, Rolle und Aufgaben in deiner Anwendung. Die Grenzen der Verfassung verschiebst du damit nicht. Wer Claude in ein eigenes Produkt einbaut, gilt als relativ vertrauenswürdig — aber nicht bedingungslos.
Was heißt das für dein Marketing?
Direkt einstellen kannst du an Constitutional AI nichts. Aber sie erklärt, warum Claude manche Bitten ablehnt und andere mit Hinweis erledigt. Und sie liefert eine brauchbare Vorlage:
- Eigene KI-Richtlinie schreiben: Was darf ein Tool in deinem Namen sagen, was nie? Ein, zwei Seiten reichen.
- Begründen statt nur verbieten: Die Verfassung von 2026 zeigt, dass Regeln mit „weil“ besser tragen als nackte Verbote — bei Menschen wie bei Modellen.
- Grenzen kennen: Wenn Claude eine Aufgabe ablehnt, hilft oft mehr Kontext zum Zweck. Gegen die Verfassung zu arbeiten, lohnt sich nicht.
Häufige Fragen
Was ist Constitutional AI einfach erklärt?
Ein Trainingsverfahren, bei dem ein Sprachmodell anhand einer schriftlichen Liste von Prinzipien lernt, was angemessen ist. Eine KI bewertet die Antworten gegen diese Liste, statt dass Menschen jede einzeln bewerten.
Was ist der Unterschied zu RLHF?
Bei RLHF bewerten Menschen, welche von zwei Antworten besser ist. Constitutional AI lässt diese Bewertung für schädliche Inhalte von einer KI machen, die sich an der Verfassung orientiert. Das skaliert besser und erspart Menschen den Blick auf problematisches Material.
Nutzen auch ChatGPT oder Gemini Constitutional AI?
Der Begriff gehört zu Anthropic und Claude. Andere Hersteller haben eigene Werte-Dokumente und Verfahren, nennen sie aber nicht Constitutional AI. Das Grundprinzip, KI-Feedback statt Menschen-Feedback, nutzen auch andere.
Ist Claudes Verfassung öffentlich?
Ja. Anthropic hat sie veröffentlicht, die Fassung von 2026 sogar unter der freien Lizenz CC0. Du darfst sie lesen, zitieren und als Vorlage für eigene Richtlinien nutzen.
Macht Constitutional AI Claude sicherer als andere Modelle?
Dafür gibt es keinen unabhängigen Vergleich. Die Methode zielt auf harmlose und zugleich hilfreiche Antworten, und Anthropics eigene Tests zeigen Fortschritte. Ein Freifahrtschein ist das nicht: Prüf Ergebnisse vor der Veröffentlichung.


