Was ist die euklidische Distanz?
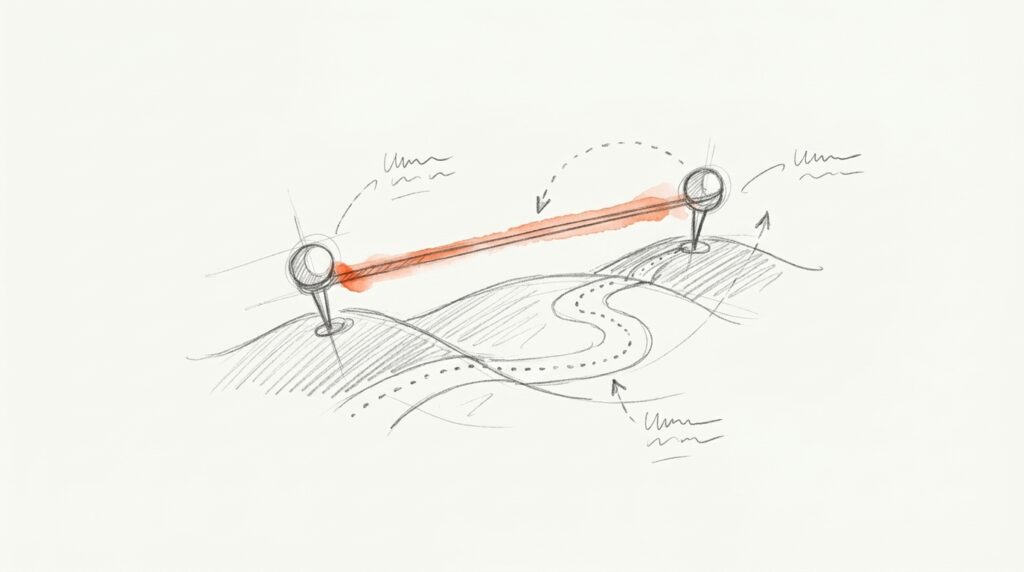
Wie weit ist es von Hamburg nach Kiel? Über die Autobahn eine Strecke, per Luftlinie eine andere. Die euklidische Distanz ist die Luftlinie: der kürzeste, gerade Weg zwischen zwei Punkten. Benannt ist sie nach dem griechischen Mathematiker Euklid.
Auf einer Karte hat ein Punkt zwei Koordinaten. In der KI hat ein Punkt oft Tausende: Ein Embedding, also die Zahlenreihe, mit der ein Modell die Bedeutung eines Textes darstellt, hat bei OpenAI standardmäßig 1.536 oder 3.072 Werte. Die euklidische Distanz funktioniert trotzdem genauso — sie misst einfach in allen Richtungen gleichzeitig.
Pinecone, ein Anbieter von Vektordatenbanken, beschreibt sie als geraden Abstand zwischen zwei Vektoren im mehrdimensionalen Raum. Google fasst es im eigenen Kurs zu maschinellem Lernen knapp: Steigt die Ähnlichkeit, sinkt die Distanz.
Wie wird sie berechnet?
Erinnerst du dich an den Satz des Pythagoras aus der Schule? c² = a² + b². Die euklidische Distanz ist genau das, nur mit beliebig vielen Achsen:
Formel
d = √( (p₁ − q₁)² + (p₂ − q₂)² + … + (pₙ − qₙ)² )
Beispiel: Punkt A = (3, 4), Punkt B = (0, 0) → d = √(9 + 16) = √25 = 5
Also: Differenz je Achse bilden, quadrieren, alles addieren, Wurzel ziehen. Das Ergebnis ist nie negativ, 0 heißt identisch. Nach oben gibt es keine feste Grenze — außer die Vektoren haben alle die Länge 1, dann liegt der Abstand zwischen 0 und 2.
Beispiel A · Kundenprofil
Drei Merkmale, zwei Kunden
(2, 5, 1)
Kunde 1: Besuche, Artikel, Klicks
(4, 1, 3)
Kunde 2
d = √(4 + 16 + 4) = √24 ≈ 4,9
Eigene Rechnung. Allein ist die Zahl wenig wert — sie sagt erst im Vergleich mit anderen Kundenpaaren etwas.
Beispiel B · Skalierungsfalle
Umsatz in Euro und Bestellungen
(1.200, 2)
Kunde A
(1.300, 10)
Kunde B
d = √(100² + 8²) ≈ 100,3
Eigene Rechnung. Der Umsatz bestimmt fast alles, obwohl B fünfmal so oft bestellt. Deshalb Merkmale vorher standardisieren.
Wo du ihr im Marketing begegnest
- Vektordatenbanken: Für semantische Suche oder einen Chatbot mit eigenem Wissen (RAG) werden Texte als Embeddings gespeichert. pgvector für PostgreSQL rechnet die euklidische Distanz mit dem Operator „<->“, Pinecone mit der Einstellung euclidean.
- Kundensegmente: Das Clustering-Verfahren k-Means teilt Kunden in Gruppen, indem es die Abstände zum jeweils nächsten Gruppenzentrum klein hält. In BigQuery ML ist die euklidische Distanz dafür die Standardeinstellung, Google nennt Kundensegmente ausdrücklich als Zweck.
- Empfehlungen: „Ähnliche Produkte“ sind oft einfach die Produkte mit dem kleinsten Abstand im Merkmalsraum.
Im Tutorial zu BigQuery ML teilt Google zum Beispiel Londoner Fahrradstationen anhand von drei Merkmalen in vier Gruppen: Mietdauer, Zahl der Fahrten und Entfernung zur Innenstadt. Dasselbe Prinzip funktioniert mit Kundendaten.
Euklidische Distanz oder Kosinus-Ähnlichkeit?
Maß
Misst
Euklidische Distanz
Luftlinie, kleiner = ähnlicher
Kosinus-Ähnlichkeit
nur den Winkel, größer = ähnlicher
Skalarprodukt
Winkel und Länge zusammen
Manhattan-Distanz
Weg entlang der Achsen
Die gute Nachricht: Bei normierten Embeddings ist es fast egal. OpenAI schreibt, dass seine Embeddings auf Länge 1 normiert sind und Kosinus-Ähnlichkeit und euklidische Distanz deshalb dieselbe Rangfolge ergeben. Google bestätigt im ML-Kurs: Bei Vektoren der Länge 1 sind alle drei Maße gleichwertig. Unterschiede gibt es dann nur beim Rechentempo und beim Wertebereich.
Häufige Fehler
Fehler 1 · Merkmale nicht skalieren
Siehe Beispiel B: Euro-Beträge erdrücken Zählwerte. Pinecone nennt die euklidische Distanz ausdrücklich empfindlich für die Skala. BigQuery ML standardisiert die Merkmale für k-Means deshalb schon von sich aus.
Fehler 2 · Werte zwischen Werkzeugen vergleichen
Google Vertex AI gibt die quadrierte Distanz aus, pgvector die echte. Ein Wert von 0,4 bedeutet also nicht überall dasselbe. Und bei Distanzen ist kleiner besser, bei Ähnlichkeiten größer — wer das vertauscht, sortiert seine Treffer verkehrt herum.
Fehler 3 · Blind in tausend Dimensionen clustern
Die Dokumentation von scikit-learn warnt: In sehr vielen Dimensionen blähen sich euklidische Distanzen auf, Fachwort Fluch der Dimensionalität. Sie empfiehlt, die Daten vorher zu verdichten, etwa per Hauptkomponentenanalyse, und k-Means mehrfach zu starten.
Häufige Fragen
Was ist der Unterschied zwischen euklidischer Distanz und Kosinus-Ähnlichkeit?
Die euklidische Distanz misst den geraden Abstand zwischen zwei Punkten, die Kosinus-Ähnlichkeit nur den Winkel zwischen ihnen. Bei normierten Vektoren, wie OpenAI sie liefert, ergeben beide dieselbe Rangfolge.
Welche Distanz soll ich für OpenAI-Embeddings nehmen?
OpenAI empfiehlt Kosinus-Ähnlichkeit, sagt aber selbst, dass die Wahl meist kaum eine Rolle spielt. Weil die Vektoren normiert sind, kommt mit euklidischer Distanz dieselbe Reihenfolge heraus.
Warum muss ich Daten vor k-Means standardisieren?
Weil sonst das Merkmal mit den größten Zahlen das Ergebnis bestimmt. Ein Umsatz in Euro überdeckt sonst die Zahl der Bestellungen, auch wenn die viel aussagekräftiger ist.
Was bedeutet ein kleiner Distanzwert in einer Vektordatenbank?
Je kleiner der Wert, desto ähnlicher sind sich die beiden Inhalte. 0 heißt identisch. Feste Schwellen gibt es nicht, sie hängen vom Modell und vom Werkzeug ab.
Was ist die L2-Distanz?
Ein anderer Name für die euklidische Distanz. Der Begriff kommt aus der Mathematik und steht so auch in pgvector und anderen Werkzeugen.