

Was ist ein Embedding?
Warum findet eine gute Suche „Laufschuhe“, wenn jemand „Sneaker zum Joggen“ eintippt? Kein Wort stimmt überein, und trotzdem passt der Treffer. Die Antwort heißt meist Embedding.
Ein Embedding ist eine Liste von Zahlen, ein sogenannter Vektor. Ein spezielles KI-Modell liest einen Text und liefert diese Liste zurück. Sie steht nicht für die Wörter, sondern für die Bedeutung.
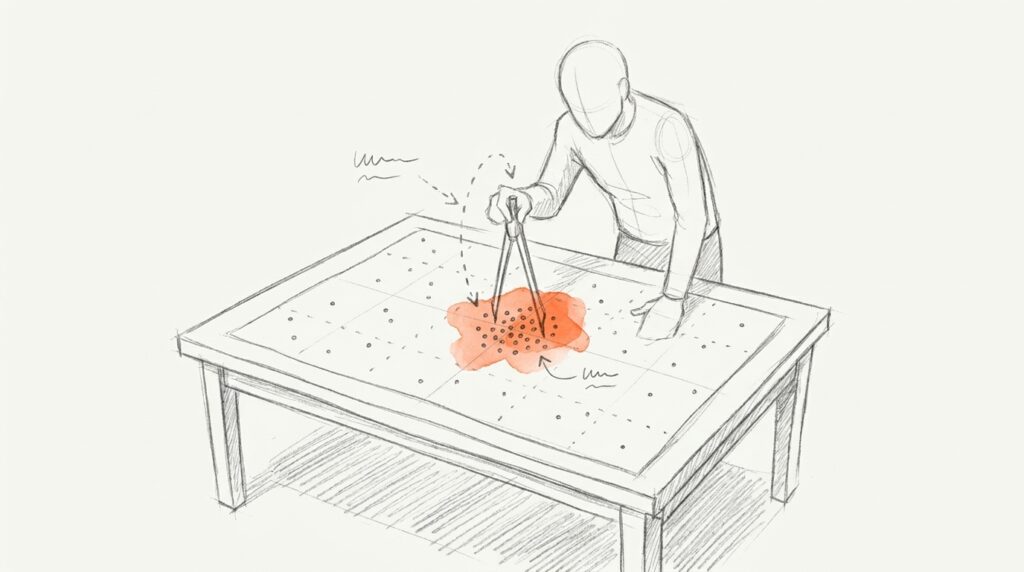
Stell dir eine riesige Landkarte vor. Jeder Text bekommt einen Punkt darauf. Texte mit ähnlicher Bedeutung liegen nah beieinander, fremde Themen weit auseinander. OpenAI sagt es so: Kleine Abstände zeigen hohe Verwandtschaft, große Abstände geringe.
So wird aus Text ein Abstand
Der Weg ist immer gleich, egal ob Blogartikel, Produkttext oder Support-Antwort:
- Zerlegen: Lange Texte werden in Abschnitte geteilt. Anthropic spricht von höchstens ein paar hundert Tokens je Stück.
- Einbetten: Das Modell macht aus jedem Abschnitt einen Vektor, meist mit 1.024 bis 3.072 Zahlen.
- Speichern: Die Vektoren landen in einer Vektordatenbank, zum Beispiel Pinecone, Qdrant oder pgvector.
- Vergleichen: Eine Suchanfrage wird genauso eingebettet. Das System holt die Vektoren mit dem kleinsten Abstand.
Gemessen wird der Abstand meist als Kosinus-Ähnlichkeit. Sie vergleicht den Winkel zwischen zwei Vektoren und reicht laut Google von -1 (gegensätzlich) bis 1 (größte Ähnlichkeit). Welches Maß du nimmst, ist laut OpenAI meist nebensächlich.
Welche Modelle gibt es, und was kosten sie?
Embeddings sind günstig. Die Preise gelten je eine Million Tokens, also Texteinheiten, Stand November 2026:
Modell
Preis
OpenAI 3-small
0,02 $
OpenAI 3-large
0,13 $
Voyage 4-lite
0,02 $
Voyage 4-large
0,12 $
Gemini Embedding 2
0,20 $
OpenAI rechnet mit rund 800 Tokens je Seite. Deine Website mit 500 Seiten hat also rund 400.000 Tokens. Das kostet mit dem kleinen Modell weniger als einen Cent, mit dem großen gut 5 Cent. Die Kosten sind fast nie das Problem. Die Arbeit steckt im sauberen Aufbau.
Anthropic bietet übrigens kein eigenes Embedding-Modell an und nennt Voyage AI als Anbieter. Gemini Embedding 2 verarbeitet neben Text auch Bilder, Audio, Video und PDF.
Wofür taugt das im Marketing?
- Onsite-Suche: Dein Shop versteht, was Kunden meinen, nicht nur, was sie tippen.
- Chatbot mit eigenem Wissen: Bei RAG sucht das System per Embedding passende Textstücke und gibt sie dem Sprachmodell mit.
- Interne Verlinkung: Screaming Frog vergleicht seit Version 22 Seiten per Embedding und zeigt ähnliche Inhalte.
- Kannibalisierung finden: Fast gleiche Artikel fallen auf, auch wenn sie anders formuliert sind.
- Keywords clustern: Tausende Suchbegriffe lassen sich nach Bedeutung gruppieren.
Case A · Onlinehandel
Semantische Suche bei JD.com
+1,29 %
Conversion Rate
+10,03 %
bei Long-Tail-Suchen
Der größte Sprung kam bei seltenen Suchanfragen.
A/B-Test eines chinesischen Handelskonzerns, 2020 veröffentlicht. Für kleine Shops ist das nur eine Richtung, kein Versprechen.
Case B · KI-Suche
Ahrefs vergleicht AI Mode und AI Overviews
86 %
ähnliche Bedeutung
13,7 %
gleiche Quellen
Gleiche Aussage, aber andere Wörter und andere Quellen.
730.000 Abfragepaare aus den USA, September 2025. Wörtlich stimmten die Antworten nur zu 16 % überein.
Häufige Fehler
Fehler 1 · Vektoren verschiedener Modelle mischen
Jedes Modell baut seine eigene Landkarte. Google schreibt sogar bei den eigenen Modellen: Die Räume sind inkompatibel. Wechselst du das Modell, bettest du alles neu ein.
Fehler 2 · Ein Englisch-Modell für deutsche Texte nehmen
Googles text-embedding-005 ist laut Modelltabelle nur für Englisch gedacht. Prüf vor dem Start, ob dein Modell Deutsch abdeckt.
Fehler 3 · Lange Texte am Stück einbetten
Bei manchen Modellen wird ab 2.048 Tokens stillschweigend abgeschnitten. Der Rest deines Textes fehlt dann einfach, und keine Fehlermeldung warnt dich. Teil lange Seiten deshalb in Abschnitte.
Fehler 4 · Exakte Begriffe unterschätzen
Artikelnummern und Fehlercodes haben kaum Bedeutung, die ein Modell fassen könnte. Anthropic hat das getestet: Mit Stichwortsuche dazu sank die Fehlerquote bei der Textsuche um 49 %. Kombinier also beide Wege.
Fehler 5 · Ähnlichkeitswerte als Schulnoten lesen
Eine 0,8 ist nicht automatisch gut. Die Werte hängen vom Modell ab. Screaming Frog stuft Seiten standardmäßig erst ab 0,95 als ähnlich ein. Eich deine Schwelle an eigenen Daten.
So startest du
Fang klein an. Du brauchst dafür weder Data Scientist noch Serverpark:
- Einen Anwendungsfall wählen: am besten Dubletten im Blog oder interne Verlinkung.
- Testlauf mit Screaming Frog: API-Schlüssel eintragen und deine Website crawlen.
- Ergebnis von Hand prüfen: Stimmen die Vorschläge? Dann erst den nächsten Schritt planen.
- Automatisieren: In n8n gibt es fertige Embedding-Knoten für Chatbots und Suchen.
Häufige Fragen
Was ist ein Embedding einfach erklärt?
Eine Zahlenliste, die die Bedeutung eines Inhalts abbildet. Wie Koordinaten auf einer Landkarte: Ähnliche Inhalte liegen nah beieinander. So erkennt ein Computer Verwandtschaft, ohne dass dieselben Wörter vorkommen.
Was kostet es, meine Website einzubetten?
Meist nur Cent-Beträge. OpenAI rechnet mit rund 800 Tokens je Seite und 0,02 $ je Million Tokens beim kleinen Modell. 500 Seiten kosten damit weniger als einen Cent. Teurer wird eher der Speicher oder die Entwicklung drumherum.
Wie viele Dimensionen brauche ich?
Für den Start reichen die Standardwerte. Mehr Dimensionen fassen mehr Feinheiten, brauchen aber mehr Speicher. OpenAI lässt seine Vektoren kürzen. Laut Hersteller schlägt das große Modell mit nur 256 Dimensionen im Benchmark noch das alte ada-002 mit 1.536.
Beeinflussen Embeddings mein Google-Ranking?
Direkt lässt sich das nicht belegen. Google nennt das Wort in seinem Ranking-Leitfaden nicht und bestätigt keine Zielwerte. Klar ist nur: Google versteht Konzepte, nicht bloß Wörter. Schreib deshalb Themen gründlich aus, statt Keywords zu stapeln.
Was ist der Unterschied zwischen Embedding und Vektordatenbank?
Das Embedding ist der Vektor selbst, also das Ergebnis des Modells. Die Vektordatenbank speichert viele davon und findet schnell die ähnlichsten. Für kleine Mengen reicht pgvector, eine Erweiterung für Postgres.
Quellen


