Was ist Model Collapse?
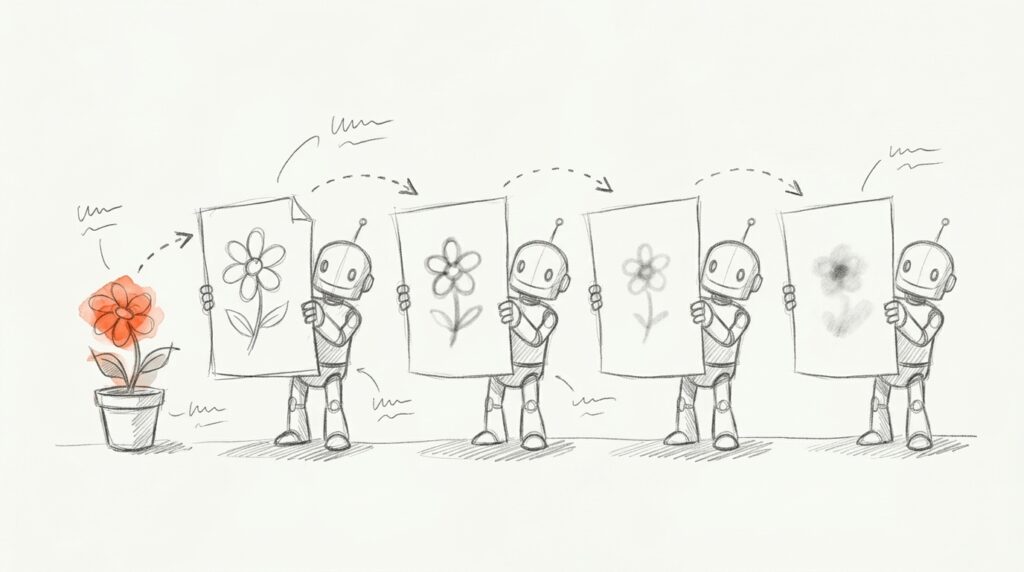
Kopier ein Foto, dann die Kopie, dann die Kopie der Kopie. Nach ein paar Runden ist nur noch Matsch übrig. Genau das droht KI-Modellen, die mit Texten oder Bildern anderer KI-Modelle trainiert werden.
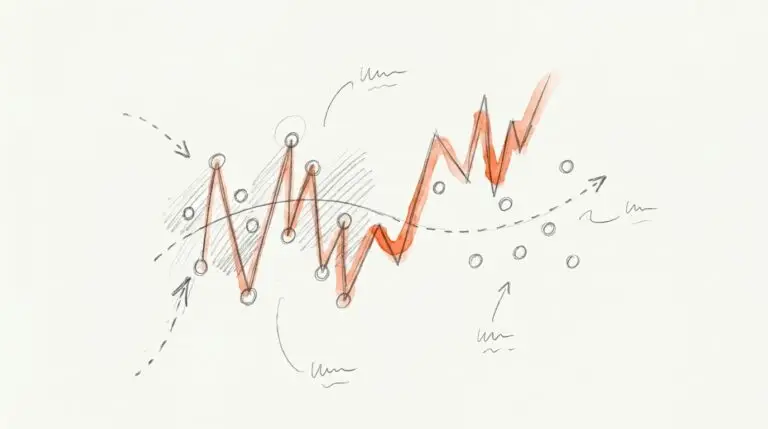
Model Collapse, auf Deutsch Modellkollaps, beschreibt diesen Abbau. Ein Forschungsteam um Ilia Shumailov hat ihn 2024 in der Fachzeitschrift Nature beschrieben. Es unterscheidet zwei Phasen:
- Früher Kollaps: Das Modell verliert die seltenen Fälle. Ungewöhnliche Formulierungen, Nischenthemen und Ausnahmen verschwinden zuerst.
- Später Kollaps: Das Modell vermischt alles zu einer Einheitssoße, die dem Original kaum noch ähnelt.
Laut den Autoren betrifft das nicht nur Sprachmodelle, sondern generative Modelle allgemein, die rekursiv auf den Ausgaben ihrer Vorgänger lernen.
Das Experiment: von Kirchtürmen zu Hasen
Im Versuch trainierten die Forscher ein kleines Sprachmodell von Meta auf Wikipedia-Texten. Jede neue Generation lernte nur noch von Texten der vorherigen.
Generation
Antwort zum Thema Kirchtürme
0
sachlich über Architektur
7
unpassendes Zitat
9
Liste über Hasen
Die Hauptursache: Jede Generation sieht nur eine Stichprobe. Kleine Fehler schaukeln sich auf, und was selten ist, fällt einfach raus. Wiederholungen im Text erklären den Effekt nicht.
Warum das fürs Marketing zählt
Studie · Web-Inhalte
Neue Webseiten (Ahrefs 2025)
900.000
neue Seiten geprüft
74,2 %
mit KI-Anteil
Das Netz füllt sich mit Maschinentext
Ahrefs prüfte im April 2025 neue englischsprachige Seiten mit einem eigenen Detektor. Nur 2,5 % waren rein KI, die meisten gemischt. Detektoren schätzen, sie messen nicht exakt.
Prognose · Trainingsdaten
Epoch AI (2024)
≈ 300 Bio.
Tokens menschlicher Text
2026–2032
aufgebraucht
Echte menschliche Daten werden knapp
Das Forschungsinstitut schätzt den Bestand an öffentlichem, menschlich geschriebenem Text mit breitem Unsicherheitsbereich. Es ist eine Prognose, keine Messung.
Die gute Nachricht für dich: Was echt ist, wird wertvoller. Eigene Kundenfragen, eigene Zahlen, eigene Erfahrungen kann keine KI aus dem Netz nachrechnen. Die Autoren der ersten Studie schrieben schon 2023, dass Daten aus echter menschlicher Interaktion an Wert gewinnen.
Häufige Fehler
Fehler 1 · „KI wird zwangsläufig dumm“
Die Nature-Studie untersucht einen Extremfall: Originaldaten werden komplett ersetzt. Werden echte Daten behalten und ergänzt, bleibt der Effekt klein. Dass heutige kommerzielle Modelle schon messbar kollabieren, ist nicht belegt.
Fehler 2 · Model Collapse mit Halluzination verwechseln
Eine Halluzination ist ein einzelner erfundener Fakt in einer Antwort. Model Collapse ist ein schleichender Verlust über mehrere Trainingsgenerationen.
Fehler 3 · KI-Anteile im Web als exakte Zahl verkaufen
Alle Zahlen dazu stammen von Detektoren mit Fehlerquote. Ahrefs zählt Seiten mit irgendeinem KI-Anteil, andere Studien nur überwiegend KI-Texte. Die Werte lassen sich nicht einfach vergleichen.
Was heißt das für deinen Content?
- Eigenes rein: echte Zahlen, Fallbeispiele, Zitate von Kunden, eigene Fotos. Das ist der Rand der Verteilung, den Maschinen verlieren.
- Keine Massenware: Google erlaubt KI-Inhalte, wertet viele Seiten ohne Mehrwert aber als Spam („scaled content abuse“).
- Herkunft kennzeichnen: Standards wie C2PA (Content Credentials) und Wasserzeichen wie SynthID von Google machen sichtbar, was von einer KI stammt.
Häufige Fragen
Was ist Model Collapse einfach erklärt?
KI-Modelle werden schlechter, wenn sie immer wieder mit Texten oder Bildern anderer KI-Modelle trainiert werden. Wie bei der Kopie einer Kopie gehen Details verloren, zuerst das Seltene.
Werden ChatGPT und Co. durch KI-Texte im Netz schlechter?
Das ist ein Risiko, aber nicht belegt. Die Anbieter filtern Trainingsdaten und mischen echte mit synthetischen Daten. Laut Forschung verhindert genau dieses Mischen den Kollaps weitgehend.
Wie viel des Webs ist schon KI-generiert?
Schätzungen schwanken. Ahrefs fand 2025 in 74,2 % neuer englischer Webseiten KI-Anteile, rein KI-geschrieben waren 2,5 %. Alle Zahlen beruhen auf Detektoren mit Fehlerquote.
Lässt sich Model Collapse verhindern?
Weitgehend ja: Originaldaten behalten, echte und synthetische Daten sammeln statt ersetzen und die Herkunft von Inhalten kennzeichnen.
Was bedeutet das für mein SEO?
Originelle, belegte Inhalte gewinnen. Massenhaft generierte Seiten ohne Mehrwert riskieren nach Googles Spam-Richtlinien Abwertung. Eigene Daten und Erfahrungen sind dein Vorteil.