

Was ist Direct Preference Optimization?
Wie bringst du einer KI bei, dass sie wie deine Marke klingt? Regeln aufschreiben ist schwer. Zwei Texte vergleichen ist leicht: „Der hier passt, der nicht.“ Genau das nutzt Direct Preference Optimization, kurz DPO.
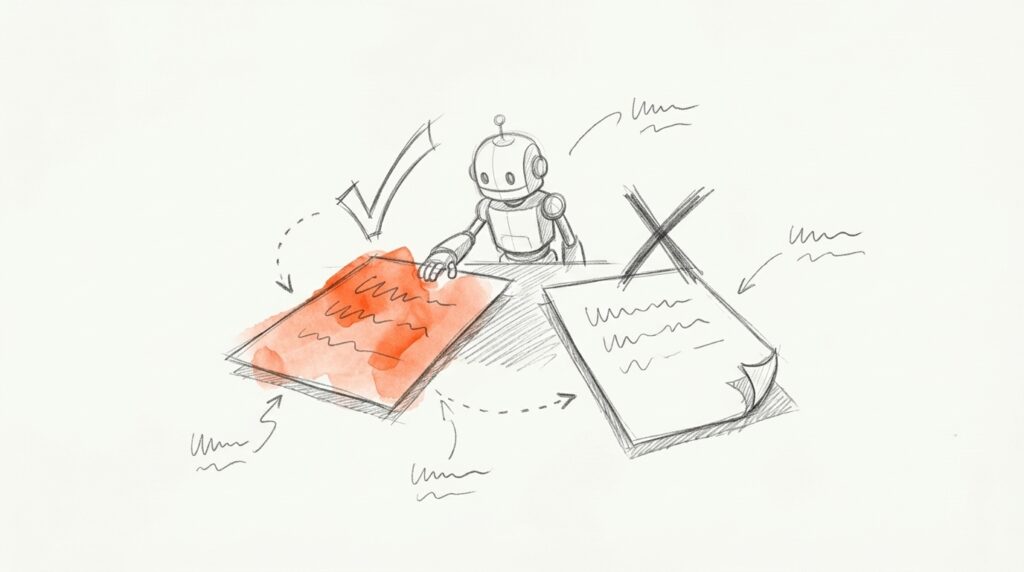
DPO ist ein Verfahren fürs Nachtrainieren von Sprachmodellen, vorgestellt 2023 von einem Team der Stanford University. Das Modell bekommt zu einem Prompt zwei Antworten: eine bevorzugte und eine abgelehnte. Es lernt, die bevorzugte Art wahrscheinlicher zu machen und die abgelehnte unwahrscheinlicher.
Der Clou steckt im Titel des Papers: Das Sprachmodell ist „heimlich ein Belohnungsmodell“. Ein separates Bewertungsmodell und aufwendiges Reinforcement Learning, also Lernen durch Belohnung, braucht es nicht mehr.
So funktioniert DPO
- Daten: Pro Beispiel ein Prompt, eine bevorzugte und eine abgelehnte Antwort. Die Bewertung kann von Menschen kommen oder von einer KI.
- Referenz: Eine eingefrorene Kopie des Modells vor dem Training dient als Anker.
- Training: Das Modell vergrößert den Abstand zwischen guter und schlechter Antwort, gemessen an dieser Referenz.
- Bremse: Ein Regler namens Beta legt fest, wie weit sich das Modell vom Ausgangszustand entfernen darf. Höher heißt vorsichtiger.
Der Vorgänger heißt RLHF (Reinforcement Learning from Human Feedback). Dort trainiert man erst ein eigenes Belohnungsmodell und optimiert dann per Reinforcement Learning. Das ist rechenintensiv und gilt als launisch. Die DPO-Autoren beschreiben ihr Verfahren dagegen als stabil und rechnerisch leicht.
Verfahren
Lernt aus
Supervised Fine-Tuning
Musterantworten
RLHF
Belohnungsmodell
DPO
Antwortpaaren
Beispiele aus der Praxis
Paper · Zusammenfassungen
DPO gegen RLHF (2023)
61 %
Siegquote DPO
57 %
Siegquote RLHF
DPO mindestens gleichauf mit dem aufwendigeren Verfahren
Siegquote gegen Referenz-Zusammenfassungen, bewertet von GPT-4. In der Menschenstudie wurden DPO-Texte in 58 % der Fälle vorgezogen.
Modell · Hugging Face
Zephyr-7B (Oktober 2023)
64.000
KI-bewertete Prompts
7,34
MT-Bench-Wert
Ein kleines Modell schlägt im Test ein zehnmal größeres
Llama2-Chat-70B kam im selben Test auf 6,86. In einem anderen Benchmark lag Llama2 knapp vorn — kein Freifahrtschein, aber ein deutliches Signal.
Auch die Großen setzen darauf: Meta nutzte DPO für Llama 3 und nahm es laut eigenem Paper statt des Reinforcement-Learning-Verfahrens PPO, weil es bei großen Modellen weniger Rechenleistung brauchte. Das Allen Institute trainierte Tülu 3 in drei Stufen, DPO ist eine davon.
Häufige Fehler
Fehler 1 · DPO ohne Vortraining
OpenAI und Google empfehlen beide, zuerst ein Supervised Fine-Tuning auf den bevorzugten Antworten zu machen. DPO ist der Feinschliff, nicht das Fundament.
Fehler 2 · Neues Wissen erwarten
DPO verändert, wie ein Modell antwortet, nicht was es weiß. Laut OpenAI passt es zu subjektiven Fragen wie Ton und Stil. Für aktuelle Fakten ist RAG das bessere Werkzeug.
Fehler 3 · Paare ohne echten Unterschied
Sind gute und schlechte Antwort fast gleich oder widersprechen sich die Bewertungen, lernt das Modell Rauschen. Jedes Paar braucht einen klaren Grund, warum die eine Antwort besser ist.
Fehler 4 · Beta falsch einstellen
Ist der Regler zu niedrig, driftet das Modell weg und verliert Fähigkeiten. Ist er zu hoch, lernt es kaum etwas. Die Bibliothek TRL von Hugging Face startet mit 0,1.
Brauchst du DPO?
Für die meisten KMU: noch nicht. Ein gut gebauter Prompt mit Beispielen deiner Markenstimme bringt dich weit. DPO wird spannend, wenn du ein offenes Modell selbst betreibst und tausende Texte im gleichen Stil brauchst.
Häufige Fragen
Was unterscheidet DPO von RLHF?
RLHF trainiert erst ein separates Belohnungsmodell und optimiert dann per Reinforcement Learning. DPO lernt direkt aus den Antwortpaaren. Das ist einfacher und braucht weniger Rechenleistung, bei vergleichbaren Ergebnissen.
Kann ich mit DPO meiner KI die Markenstimme beibringen?
Ja, genau dafür eignet es sich: Ton und Stil sind subjektiv und lassen sich gut als „lieber so als so“ ausdrücken. Du brauchst dafür aber ein Modell, das du nachtrainieren darfst, und genug Paare.
Wie viele Antwortpaare brauche ich?
Eine offizielle Mindestzahl nennen weder OpenAI noch Google noch Hugging Face. Zum Vergleich: Zephyr wurde mit rund 64.000 KI-bewerteten Prompts trainiert. Für einen engen Stil reichen deutlich weniger, aber eher hunderte als zehn.
Brauche ich vorher ein normales Fine-Tuning?
Empfohlen ist es. OpenAI und Google raten, zuerst mit den bevorzugten Antworten ein Supervised Fine-Tuning zu machen und DPO danach als Feinschliff einzusetzen.
Ist DPO dasselbe wie der Datenschutzbeauftragte?
Nein. Im Datenschutz steht DPO für Data Protection Officer. In der KI meint DPO das Trainingsverfahren Direct Preference Optimization.


