

Was ist ein Generative Pre-trained Transformer?
GPT steht für Generative Pre-trained Transformer. Das ist eine Bauart von Sprachmodellen, die OpenAI 2018 vorgestellt hat. Jeder der drei Wortteile beschreibt ein Stück davon, wie das Modell arbeitet:
- Generative: Das Modell erzeugt neuen Text, statt nur vorhandenen einzuordnen.
- Pre-trained: Es wird zuerst allgemein vortrainiert — auf riesigen Mengen Text, ohne dass jemand die Daten von Hand beschriftet. Erst danach wird es für Aufgaben wie Chatten angepasst.
- Transformer: die Architektur des neuronalen Netzes, die Google-Forscher 2017 im Paper „Attention Is All You Need“ beschrieben haben.
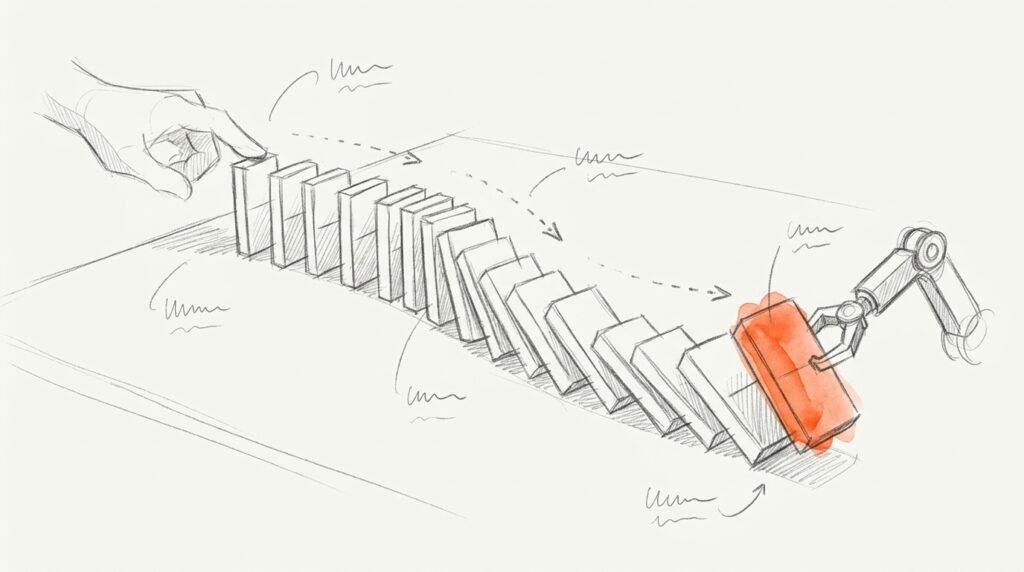
Der Kern ist verblüffend schlicht. Laut dem GPT-4-Bericht von OpenAI ist das Modell darauf trainiert, das nächste Token vorherzusagen — also das nächste Wort oder Wortstück. Aus vielen solchen Vorhersagen hintereinander entsteht ein ganzer Text. Das ist wie Dominosteine aufstellen: Jeder neue Stein hängt an den vorherigen.
Von GPT-1 bis heute
Die Modelle sind in wenigen Jahren um mehr als den Faktor tausend gewachsen. Die Parameter — grob gesagt die einstellbaren Stellschrauben im Netz — hat OpenAI aber nur bis GPT-3 veröffentlicht.
Modell
Parameter
GPT-1 (2018)
rund 117 Mio.
GPT-2 (2019)
1,5 Mrd.
GPT-3 (2020)
175 Mrd.
GPT-4 (2023)
nicht veröffentlicht
GPT-1 lernte noch aus über 7.000 unveröffentlichten Büchern. GPT-2 bekam schon 40 Gigabyte Text aus rund 8 Millionen Webseiten. Für GPT-4 schreibt OpenAI ausdrücklich, dass der Bericht keine Angaben zu Modellgröße, Rechenaufwand oder Trainingsdaten enthält. Zahlen wie „1,76 Billionen Parameter“, die für GPT-4 kursieren, sind deshalb nicht belegt.
Danach ging es schnell: GPT-4o (Mai 2024), GPT-5 (August 2025), im September 2026 dann GPT-6. Die Namen wechseln oft, und „GPT“ steht bei OpenAI inzwischen auch vor Bild- und Sprachmodellen. Welches Modell gerade das neueste ist, siehst du auf der Modellseite von OpenAI.
Gibt es offene GPT-Modelle?
Ja. Im August 2025 hat OpenAI mit gpt-oss zwei Modelle veröffentlicht, deren Gewichte frei unter der Apache-2.0-Lizenz stehen. Du kannst sie also selbst betreiben und auch kommerziell nutzen.
Variante A · klein
gpt-oss-20b
21 Mrd.
Parameter
16 GB
Speicher reichen
Läuft auf einem gut ausgestatteten Rechner im Büro
Spannend, wenn Kundendaten das Haus nicht verlassen sollen. Lokal starten lässt es sich etwa mit Ollama oder LM Studio.
Variante B · groß
gpt-oss-120b
117 Mrd.
Parameter
5,1 Mrd.
davon je Token aktiv
Passt auf eine einzelne 80-GB-Grafikkarte
Das Modell aktiviert pro Wort nur einen kleinen Teil seiner Parameter (Mixture of Experts). Für KMU meist eher über Anbieter wie Hugging Face oder OpenRouter nutzbar.
Häufige Fehler
Fehler 1 · GPT für den Oberbegriff halten
Nicht jedes Sprachmodell ist ein GPT. Gemini, Llama oder Claude sind ebenfalls Large Language Models, aber keine GPT-Modelle. GPT ist die Bauart und Modellfamilie von OpenAI, Large Language Model der Oberbegriff.
Fehler 2 · „Das Modell versteht, was es schreibt“
Ein GPT sagt das wahrscheinlich nächste Wort voraus. Das klingt oft klug — und ist trotzdem kein Verstehen wie beim Menschen. Darum erfindet es manchmal selbstbewusst Fakten. Prüf jede Zahl, die ein GPT dir liefert.
Fehler 3 · GPT für eine geschützte Marke halten
Das US-Markenamt hat OpenAIs Antrag auf die Marke „GPT“ 2024 endgültig abgelehnt: Der Begriff beschreibe nur eine Eigenschaft der Produkte. Andere Firmen nutzen „GPT“ deshalb auch. Für Kunden der OpenAI-Schnittstelle gelten aber eigene Regeln zur Namensgebung — wer ein Tool „Irgendwas-GPT“ nennen will, sollte die aktuellen Markenrichtlinien von OpenAI lesen.
Was heißt das für dein Marketing?
- Werkzeug, nicht Orakel: GPT-Modelle sind stark bei Entwürfen, Varianten, Zusammenfassungen und Umformulierungen.
- Modell bewusst wählen: Für einfache Aufgaben reicht ein kleines, günstiges Modell, für knifflige Analysen lohnt das große.
- Daten im Blick behalten: Kundendaten nur dort einfüttern, wo du weißt, wo sie landen — notfalls mit einem offenen Modell im eigenen Haus.
Häufige Fragen
Wofür steht GPT?
GPT steht für Generative Pre-trained Transformer: ein Sprachmodell, das Text erzeugt (generative), vorab auf großen Textmengen trainiert wurde (pre-trained) und auf der Transformer-Architektur beruht.
Was ist der Unterschied zwischen GPT und ChatGPT?
GPT ist die Modellfamilie von OpenAI. ChatGPT ist die Chat-Anwendung, die auf GPT-Modellen läuft und Ende 2022 gestartet ist. Über die Schnittstelle von OpenAI kannst du GPT-Modelle auch ohne ChatGPT in eigene Werkzeuge einbauen.
Wie viele Parameter hat GPT-4?
Das ist nicht bekannt. OpenAI hat für GPT-4 und alle späteren Modelle keine Parameterzahl veröffentlicht. Zuletzt offiziell genannt wurden 175 Milliarden für GPT-3.
Gibt es GPT-Modelle, die ich selbst betreiben kann?
Ja. Seit August 2025 gibt es gpt-oss-20b und gpt-oss-120b mit frei verfügbaren Gewichten unter Apache-2.0-Lizenz. Das kleinere Modell läuft schon mit 16 GB Speicher.
Ist GPT eine geschützte Marke?
In den USA nicht: Das Markenamt hat den Antrag von OpenAI 2024 endgültig abgelehnt, weil der Begriff nur beschreibend sei. In anderen Ländern ist die Lage unterschiedlich, und OpenAI hat eigene Regeln für Kunden seiner Schnittstelle.
Quellen
- arXiv: Attention Is All You Need (2017)
- OpenAI: Improving Language Understanding by Generative Pre-Training (2018)
- OpenAI: Language Models are Unsupervised Multitask Learners (2019)
- arXiv: Language Models are Few-Shot Learners (2020)
- arXiv: GPT-4 Technical Report (2023)
- OpenAI-Entwicklerdoku: Changelog
- arXiv: gpt-oss Model Card (2025)


