

Was ist ein Transformer?
Warum versteht ChatGPT, was „es“ in deinem dritten Satz meint? Die Antwort heißt Transformer. So nennt sich eine Bauart neuronaler Netze, die Google-Forschende im Juni 2017 im Paper „Attention Is All You Need“ vorgestellt haben.
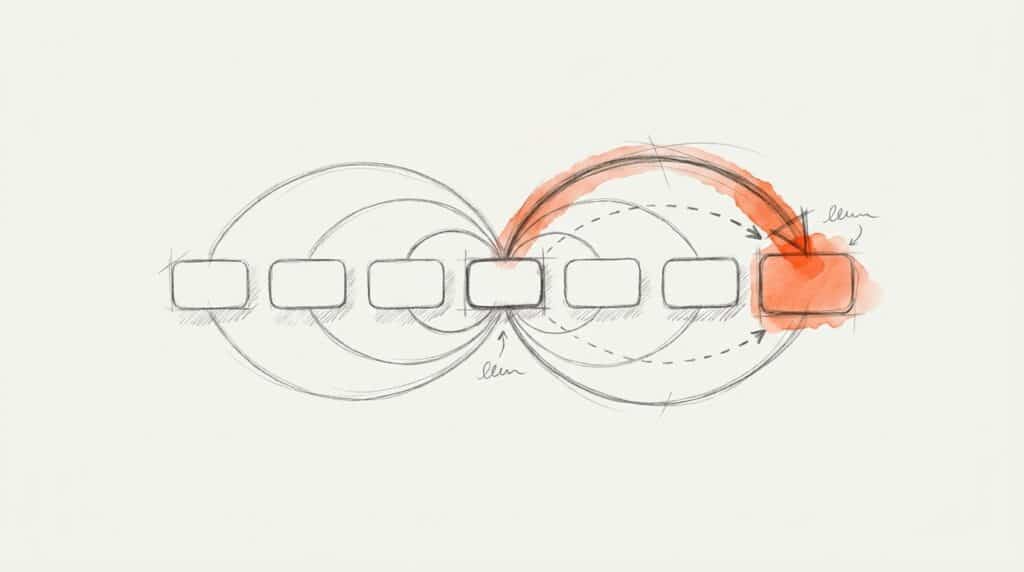
Der Kern ist eine einfache Idee: Ältere Modelle lasen Texte Wort für Wort, wie du eine lange Zahl vorliest. Ein Transformer schaut auf alle Wörter gleichzeitig und bewertet, welche zueinander gehören. Der Mechanismus dafür heißt Self-Attention, also Selbst-Aufmerksamkeit: Jedes Wort prüft, welche anderen Wörter für seine Bedeutung wichtig sind.
Googles Beispiel: Um „bank“ im Englischen als Flussufer zu erkennen, schaut der Transformer direkt auf „river“, in einem einzigen Schritt. Ein älteres Modell musste alle Wörter dazwischen nacheinander abarbeiten.
So arbeitet ein Transformer
Du brauchst keine Mathematik, um das Prinzip zu verstehen. Es sind vier Schritte:
- Zerlegen: Der Text wird in Token geteilt, das sind kleine Texteinheiten, oft Wortteile.
- Übersetzen: Jedes Token wird zu Zahlen, einem sogenannten Embedding.
- Gewichten: Self-Attention verrechnet jedes Token mit allen anderen, über mehrere Schichten hinweg.
- Vorhersagen: Das Modell berechnet, welches Token als Nächstes am wahrscheinlichsten folgt, und wiederholt das.
Der letzte Punkt ist der wichtigste. OpenAI beschreibt GPT-4 als Modell, das darauf trainiert ist, das nächste Token vorherzusagen. Ein Transformer schlägt also nichts nach. Er setzt fort, was statistisch passt.
Damals
Modell
2017
Originalmodell: 6 + 6 Schichten, 8 GPUs, 3,5 Tage Training
2020
GPT-3: 175 Mrd. Parameter, 2.048 Token Kontext
2026
Große Anbieter: rund 1 Mio. Token Kontext
Das Kontextfenster ist die Textmenge, die ein Modell auf einmal verarbeitet. Von 2.048 auf rund 1 Million Token ist das etwa das 488-Fache (eigene Rechnung, Stand November 2026). Laut Anthropic entsprechen 1 Million Token rund 555.000 Wörtern.
Wo dir der Transformer im Marketing begegnet
Transformer stecken nicht nur in Chatbots. Zwei Fälle mit echten Zahlen zeigen die Spannweite:
Case A · Google-Suche
BERT versteht Suchanfragen
1 von 10
US-Suchen, 2019
fast jede
englische Suche, 2020
Innerhalb eines Jahres wurde aus dem Zusatz Standard.
BERT ist ein Transformer-Modell von Google. Für SEO heißt das: Google liest Sätze im Zusammenhang, nicht nur Keywords.
Case B · KI-Suche
Tow Center prüft acht KI-Suchtools
1.600
Abfragen
> 60 %
falsche Antworten
Quellen wurden oft falsch zugeordnet, und zwar im Brustton der Überzeugung.
Getestet wurde das Zuordnen von Nachrichtenartikeln im Februar 2025, nicht allgemeines Wissen. Die Tools sind inzwischen weiter.
Was das für deine Arbeit mit KI heißt
Aus der Bauart folgen drei Regeln, die dir im Alltag mehr bringen als jede Prompt-Vorlage.
Wähle aus, was du mitgibst. Weil jedes Token mit jedem anderen verrechnet wird, wächst der Aufwand im Quadrat: 1.000 Token ergeben eine Million Paare. Anthropic spricht deshalb von einem begrenzten Aufmerksamkeitsbudget. Das Briefing zählt mehr als das komplette Archiv.
Prüfe Fakten. OpenAI-Forschende erklären Halluzinationen so: Sprachmodelle sind wie gute Prüflinge trainiert, und bei Unsicherheit bringt Raten mehr Punkte. Besonders anfällig sind Einzelfakten wie Daten, Namen und Zahlen, die in den Trainingsdaten selten vorkommen.
Gib dem Modell Quellen. Es weiß nur, was es gelernt hat oder was du ihm mitgibst. Wer Preisliste, Produktdaten oder Studie direkt in den Prompt legt, senkt das Rate-Risiko.
Häufige Fehler
Fehler 1 · Größeres Kontextfenster für besser halten
Mehr Platz heißt nicht mehr Qualität. Anthropic schreibt selbst, dass mehr Kontext nicht automatisch besser ist, weil Genauigkeit und Erinnerung mit wachsender Tokenzahl nachlassen.
Fehler 2 · Kontextfenster und Wissen verwechseln
Das Kontextfenster ist das Arbeitsgedächtnis dieser einen Unterhaltung. Es hat mit den Trainingsdaten nichts zu tun, und auch die Antwort des Modells zählt mit hinein.
Fehler 3 · „Die KI lügt“
Lügen setzt Absicht voraus. Das Modell sagt das nächste Token voraus. Klingt eine falsche Fortsetzung plausibel, kommt sie eben. Dat ist kein Charakterfehler, sondern Bauart.
Fehler 4 · Die BERT-Zahl falsch zitieren
„BERT betraf 2019 zehn Prozent aller Suchen“ stimmt so nicht. Die Angabe galt nur für englische Suchen in den USA. Die oft genannten 15 % meinen etwas anderes: Anfragen, die Google noch nie gesehen hatte.
Häufige Fragen
Was ist der Unterschied zwischen Transformer und LLM?
Der Transformer ist der Bauplan, das Large Language Model das fertig trainierte Ergebnis. Die großen Sprachmodelle bauen auf dieser Architektur auf. Zwingend ist das nicht: In der Forschung gibt es Alternativen wie Mamba, die ohne Attention auskommen.
Wofür steht das T in ChatGPT?
Für Transformer. GPT ist die Modellreihe von OpenAI, ChatGPT die Anwendung, mit der du schreibst. Belegt ist die Architektur für GPT-4, das OpenAI im technischen Bericht als Transformer-basiert beschreibt. Zu den neuesten Modellen legen die Hersteller kaum noch Details offen.
Hat der Transformer etwas mit meinem Google-Ranking zu tun?
Indirekt ja. Google nutzt mit BERT seit 2019 ein Transformer-Modell, um Suchanfragen im Zusammenhang zu verstehen. Optimieren lässt sich darauf nicht direkt. Schreib klare Sätze für echte Fragen, dann passt es.
Warum erfinden Transformer-Modelle Fakten?
Weil sie das wahrscheinlichste nächste Token berechnen, nicht die Wahrheit prüfen. Beim Training lohnt sich Raten mehr als Schweigen. Fehlt ein Fakt im Kontext, füllen sie die Lücke mit etwas Plausiblem. Deshalb gehören Quellen in den Prompt und ein Mensch ans Ende.
Erzeugen auch Bildgeneratoren ihre Bilder mit Transformern?
Teilweise. Bildgeneratoren arbeiten meist als Diffusionsmodell, klassisch mit einem anderen Netz, dem U-Net. Stable Diffusion 3 nutzt dagegen eine Transformer-Architektur. Beides ist also kein Gegensatz, sondern lässt sich kombinieren.
Quellen
- Vaswani et al.: Attention Is All You Need (2017)
- Google Research: Transformer
- OpenAI: GPT-4 Technical Report
- Brown et al.: GPT-3 (2020)
- Anthropic: Effective context engineering
- Anthropic: Modellübersicht
- Google: Understanding searches better than ever before
- Google: How AI is powering a more helpful Google
- Tow Center: AI Search Has A Citation Problem
- Stanford HAI: AI Index 2026, Responsible AI
- Kalai et al.: Why Language Models Hallucinate (2025)


