Was ist eine KI-Evaluation?
Du hast einen Prompt für Produktbeschreibungen gebaut. Drei Ergebnisse sehen super aus. Heißt das, er funktioniert? Nein. Es heißt, dass drei Ergebnisse super aussehen.
Eine KI-Evaluation, im Fachjargon kurz Evals, prüft die Ausgaben eines KI-Systems systematisch gegen festgelegte Testfälle und Kriterien. OpenAI beschreibt Evals als strukturierte Tests, die die Leistung eines Modells messen — gerade weil Sprachmodelle bei gleicher Eingabe nicht immer dasselbe antworten.
Geprüft werden kann alles, was eine KI ausgibt: Texte, Antworten eines Chatbots, Klassifikationen, Zusammenfassungen oder die Schritte eines KI-Agenten.
So funktioniert eine Eval
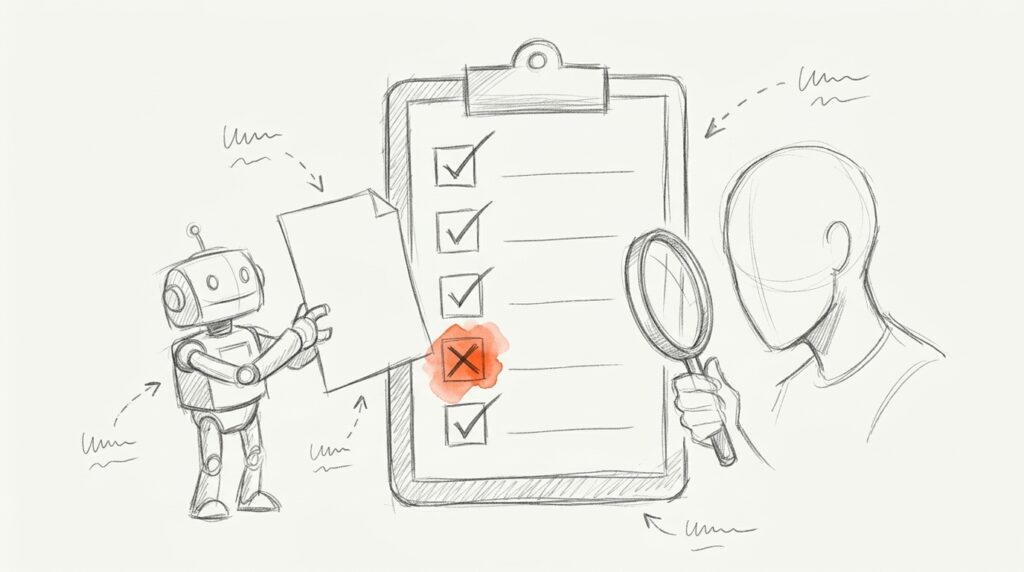
Jede Eval hat drei Teile: Testfälle (Eingaben, oft mit Musterantwort), Kriterien (was ist „gut“?) und eine Bewertung. Für die Bewertung gibt es drei Wege:
- Code-Checks: Regeln, die ein Skript prüft — Länge, Pflicht-Keyword, verbotene Wörter, gültiges JSON. Schnell, billig, eindeutig.
- LLM-as-a-Judge: Ein zweites Sprachmodell bewertet die Ausgabe nach einer Rubrik, etwa „trifft die Markenstimme: ja/nein“. Gut für weiche Kriterien.
- Menschliche Bewertung: Fachleute lesen und urteilen. Am genauesten, aber teuer und langsam.
Anthropic rät in seiner Doku zu einer klaren Gewichtung: lieber mehr Testfälle mit automatischer, etwas gröberer Bewertung als wenige, die von Hand benotet werden. Außerdem soll ein anderes Modell bewerten als das, das die Ausgabe geschrieben hat.
Das Ergebnis ist meist eine einfache Bestehensquote: bestandene Testfälle geteilt durch alle Testfälle. Google empfiehlt im Evaluationsdienst von Vertex AI genau solche Pass/Fail-Tests, zugeschnitten auf jeden einzelnen Prompt.
Taugt KI als Richter?
Erstaunlich gut — mit Haken. In einer Studie von 2023 (Zheng et al., MT-Bench) war sich GPT-4 als Richter mit menschlichen Bewertern in über 80 % der Fälle einig. Das ist etwa so oft, wie sich Menschen untereinander einig waren. Die Zahl gilt allerdings nur, wenn man Unentschieden herausrechnet.
Schwäche des KI-Richters
Befund
Reihenfolge
Bei vertauschten Antworten nur 65 % gleiches Urteil
Erste Position
In 30 % der Fälle bevorzugt
Mit Beispielen
Konsistenz steigt auf 77,5 %
Die Werte stammen aus derselben Studie, geprüft wurde damals GPT-4. Heutige Modelle sind darin nicht getestet. Die Lehre bleibt: Lass den Richter jede Paarung in beiden Reihenfolgen bewerten und prüf eine Stichprobe selbst.
Beispiele aus der Praxis
Umfrage · Verbreitung
State of Agent Engineering 2025
52,4 %
nutzen Offline-Evals
29,5 %
nutzen gar keine
Fast jedes dritte Team testet überhaupt nicht
Umfrage von LangChain unter 1.340 Teilnehmern, Ende 2025. Herstellerumfrage mit Selbstauskunft — aber die Tendenz ist deutlich.
Doku · Erfolgskriterien
Beispielziele von Anthropic
< 0,1 %
toxische Ausgaben
10.000
Testausgaben
Kriterien messbar formulieren statt „soll gut sein“
Anthropic zeigt in seiner Doku solche Ziele als Muster, angelehnt an SMART: spezifisch, messbar, erreichbar, relevant.
Für ein KMU sieht das kleiner aus: 50 echte Produktdaten als Testfälle, ein Skript prüft Länge und verbotene Superlative, ein KI-Richter prüft die Tonalität. Änderst du den Prompt, läuft der Test erneut — und du siehst schwarz auf weiß, ob es besser wurde.
Häufige Fehler
Fehler 1 · Nach Gefühl testen
OpenAI nennt es „vibe-based evals“: ein paar Eingaben ausprobieren und nicken. Das findet die Fehler nicht, die erst bei der hundertsten Anfrage auftauchen.
Fehler 2 · Nur schöne Testfälle
Echte Kunden schreiben Tippfehler, halbe Sätze und Fragen, die nicht zu deinem Angebot passen. Gehören solche Grenzfälle nicht in die Testfälle, testest du eine Welt, die es nicht gibt.
Fehler 3 · Den Richter nie prüfen
Ein KI-Richter hat eigene Vorlieben, etwa für die erste oder die längere Antwort. Gleich ihn mit einer Stichprobe deiner eigenen Urteile ab, bevor du ihm vertraust.
Fehler 4 · Einmal testen und fertig
Neues Modell, neuer Prompt, neue Produktdaten — jede Änderung kann Altes kaputt machen. Evals lohnen sich erst richtig, wenn sie nach jeder Änderung wieder laufen.
So startest du
- Kriterien aufschreiben: Was muss eine gute Ausgabe erfüllen? Drei bis fünf Punkte reichen.
- Testfälle sammeln: echte Eingaben aus deinem Alltag, plus ein paar fiese Grenzfälle.
- Bewertung wählen: Was ein Skript prüfen kann, prüft ein Skript. Den Rest bewertet ein KI-Richter mit Ja/Nein-Fragen.
- Werkzeug: Promptfoo (Open Source), Ragas für Chatbots mit eigener Wissensbasis, LangSmith, Braintrust oder DeepEval. Für den Anfang reicht auch eine Tabelle.
Häufige Fragen
Brauche ich Evals, wenn ich nur ChatGPT für Texte nutze?
Für einzelne Texte, die du selbst gegenliest, nicht. Sobald ein Prompt regelmäßig viele Texte erzeugt oder ein Chatbot direkt mit Kunden spricht, ja. Dann liest niemand mehr jede Ausgabe.
Kann eine KI die Arbeit einer anderen KI fair bewerten?
Erstaunlich oft. In der MT-Bench-Studie von 2023 war sich GPT-4 mit Menschen etwa so einig wie Menschen untereinander. Der Richter bevorzugt aber gern die erste oder längere Antwort — deshalb Reihenfolge tauschen und Stichproben selbst prüfen.
Wie viele Testfälle brauche ich?
Eine feste Zahl gibt es nicht. Fang mit ein paar Dutzend echten Fällen an und ergänze jeden Fehler, der im Betrieb auffällt. Anthropic rät: lieber viele automatisch bewertete Fälle als wenige von Hand benotete.
Was ist der Unterschied zwischen Eval und A/B-Test?
Ein A/B-Test misst die Wirkung live an echten Nutzern, etwa Klicks oder Käufe. Eine Eval prüft vorher die Qualität der Ausgaben. Beides ergänzt sich.
Gibt es kostenlose Tools?
Ja. Promptfoo, Ragas und DeepEval sind Open Source. Kosten entstehen dann nur für die Modellaufrufe, auch für den KI-Richter.