Was ist eine Konfusionsmatrix?
Ein Modell sagt voraus: Kauft dieser Lead oder nicht? Kündigt dieser Kunde oder nicht? Ist diese Sitzung ein Bot oder ein Mensch? Hinterher weißt du, was wirklich passiert ist. Die Konfusionsmatrix legt beides nebeneinander.
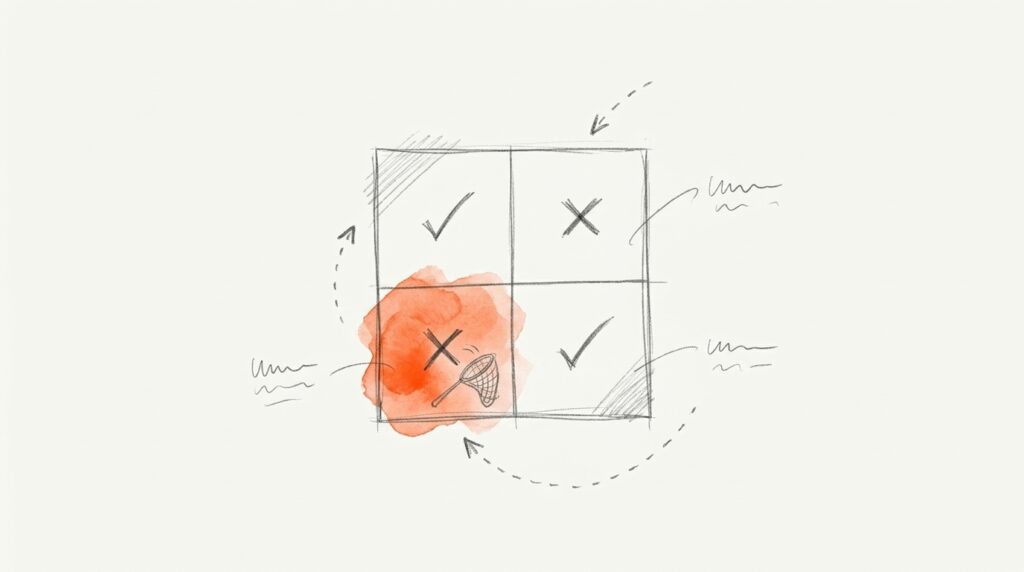
Bei einer Ja-Nein-Frage hat sie genau vier Felder:
Feld
Bedeutung
Richtig positiv
„Kauft“ gesagt, hat gekauft
Falsch positiv
„Kauft“ gesagt, hat nicht gekauft
Falsch negativ
„Kauft nicht“ gesagt, hat gekauft
Richtig negativ
„Kauft nicht“ gesagt, hat nicht gekauft
Im Englischen heißen die Felder True Positive (TP), False Positive (FP), False Negative (FN) und True Negative (TN). Google erklärt sie in seinem Machine-Learning-Kurs am Spamfilter: Ein falsch positiver Fall ist eine normale Mail, die im Spam-Ordner landet.
Was du aus den vier Feldern rechnest
- Accuracy (Korrektklassifikationsrate): (TP + TN) ÷ alle Fälle. Wie oft lag das Modell insgesamt richtig?
- Precision: TP ÷ (TP + FP). Wie viele der Markierten sind echte Treffer?
- Recall: TP ÷ (TP + FN). Wie viele der echten Fälle hat das Modell gefunden?
- Spezifität: TN ÷ (TN + FP). Wie gut erkennt es die Negativen?
- F1-Score: Mittel aus Precision und Recall.
Noch ein Punkt, der oft untergeht: Die Matrix gilt immer nur für einen Schwellenwert. Ein Modell gibt meist eine Wahrscheinlichkeit aus, etwa 0,63. Ab welchem Wert du „kauft“ sagst, legst du fest. BigQuery ML nimmt standardmäßig 0,5. Schiebst du den Schwellenwert, entsteht eine andere Matrix.
Beispiele aus der Praxis
Zwei durchgerechnete Beispiele mit ausgedachten, aber realistischen Zahlen:
Case A · Lead-Scoring
1.000 Leads, 100 kaufen wirklich
70 / 80
richtig / falsch positiv
30 / 820
falsch / richtig negativ
Accuracy 89 % · Precision 46,7 % · Recall 70 %
Die Regel „alle sind kalt“ käme auf 90 % Accuracy — höher als das Modell. Gefunden hätte sie aber keinen einzigen Käufer.
Case B · Churn-Vorhersage
5.000 Abos, 250 kündigen
200 / 200
richtig / falsch positiv
50 / 4.550
falsch / richtig negativ
Accuracy 95 % · Precision 50 % · Recall 80 %
95 % schafft auch „niemand kündigt“. Der Wert des Modells steckt im Recall: Es findet 200 von 250 Kündigern.
Häufige Fehler
Fehler 1 · Accuracy als Hauptzahl
Käufer, Kündiger, Betrüger und Bots sind fast immer selten. Dann sieht jede Accuracy gut aus. Schau auf Precision und Recall, nicht auf die Gesamtquote.
Fehler 2 · Beide Fehler gleich teuer behandeln
Ein übersehener Kündiger kostet dich einen Kunden. Ein unnötig verschickter Halte-Rabatt kostet ein paar Euro. Google rät: Recall zählt mehr, wenn falsch negative Fälle teurer sind. Rechne die Kosten beider Fehler aus, bevor du ein Modell lobst.
Fehler 3 · Achsen verwechseln
Wer Zeilen und Spalten vertauscht, vertauscht Precision und Recall. Prüf die Beschriftung jeder Matrix, die dir ein Tool oder Dienstleister zeigt.
Fehler 4 · Kleine Zahlen überbewerten
Google zeigt: Bei nur vier echten Negativen macht ein einziger Fehler die Falsch-positiv-Rate zu 25 %, ein zweiter zu 50 %. Bei wenigen Fällen springen die Quoten wild.
So baust du dir eine Konfusionsmatrix
- Ohne Code: In Excel oder Google Sheets je eine Spalte „tatsächlich“ und „vorhergesagt“, dann die vier Felder mit ZÄHLENWENNS zählen.
- Mit Python: scikit-learn liefert die Funktionen confusion_matrix und ConfusionMatrixDisplay.
- Im Data Warehouse: BigQuery ML hat die Funktion ML.CONFUSION_MATRIX für trainierte Modelle.
Häufige Fragen
Was ist der Unterschied zwischen falsch positiv und falsch negativ?
Falsch positiv heißt: Das Modell sagt „ja“, obwohl es „nein“ ist — ein Fehlalarm. Falsch negativ heißt: Das Modell sagt „nein“, obwohl es „ja“ ist — ein übersehener Fall.
Warum ist eine hohe Accuracy beim Lead-Scoring oft wertlos?
Weil Käufer selten sind. Wenn nur 10 % der Leads kaufen, erreicht schon die Regel „niemand kauft“ 90 % Accuracy. Ob ein Modell etwas taugt, zeigen Precision und Recall.
Ist Wahrheitsmatrix dasselbe wie Konfusionsmatrix?
Ja. Die deutsche Wikipedia führt den Begriff unter Wahrheitsmatrix, im Machine Learning ist Konfusionsmatrix oder Confusion Matrix verbreiteter. Gemeint ist dieselbe Tabelle.
Was hat der Schwellenwert mit der Konfusionsmatrix zu tun?
Ein Modell gibt meist eine Wahrscheinlichkeit aus. Erst der Schwellenwert macht daraus ein Ja oder Nein. Ein höherer Schwellenwert senkt in der Regel die falsch positiven Fälle, ein niedrigerer die falsch negativen. Jede Einstellung ergibt eine eigene Matrix.
Brauche ich dafür Programmierkenntnisse?
Nein. Für eine einfache Ja-Nein-Vorhersage reicht eine Tabellenkalkulation mit zwei Spalten und vier Zählformeln. Python lohnt sich erst bei vielen Modellen oder Klassen.