Was ist Latent Dirichlet Allocation?
Latent Dirichlet Allocation, kurz LDA, ist ein Verfahren aus dem Topic Modeling. Du gibst ihm einen Stapel Texte — Bewertungen, Support-Tickets, Umfrage-Antworten — und es findet darin Themen, ohne dass du vorher sagst, welche es gibt.
Erfunden haben es David Blei, Andrew Ng und Michael Jordan. Ihr Paper erschien 2003 im Journal of Machine Learning Research und ist eines der meistzitierten im Bereich: Laut OpenAlex kommt es auf über 46.000 Zitationen (Stand November 2026).
Die Grundidee ist einfach:
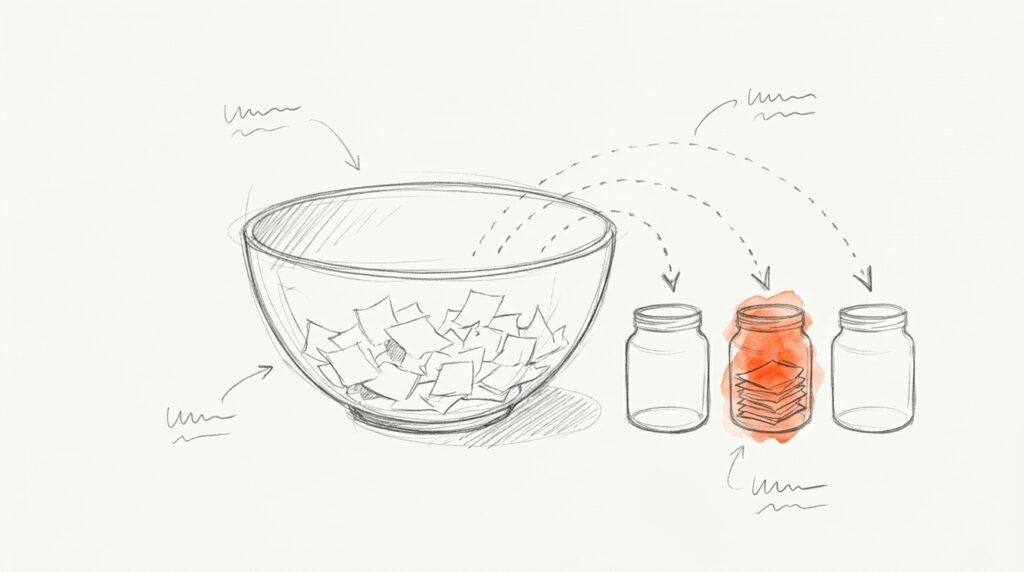
- Jedes Thema ist eine Liste typischer Wörter mit Gewicht — etwa „Lieferung, Paket, Tage, spät“.
- Jeder Text ist eine Mischung aus Themen — etwa 70 % Lieferung, 30 % Preis.
- LDA rechnet rückwärts: Es sieht nur die Wörter und schätzt daraus Themen und Mischungen.
Die Stellschrauben
LDA hat drei Regler, die über das Ergebnis entscheiden:
- Themenzahl k: Wie viele Themen soll LDA finden? Das musst du vorgeben.
- Alpha: Mischt ein Text eher wenige oder viele Themen?
- Beta (auch Eta): Wird ein Thema von wenigen oder vielen Wörtern getragen?
Wie willkürlich die Voreinstellungen sind, zeigt ein Blick in die zwei bekanntesten Bibliotheken: scikit-learn startet mit 10 Themen, gensim mit 100. Einen richtigen Wert gibt es nicht. Du probierst mehrere aus und vergleichst.
Zum Vergleichen gibt es Kohärenz-Maße. gensim bietet etwa u_mass, c_v, c_uci und c_npmi. Sie schätzen, ob die Wörter eines Themas wirklich zusammengehören. Aber Vorsicht: Eine Studie von 2009 („Reading Tea Leaves“) zeigte, dass statistisch bessere Modelle Themen liefern können, die Menschen weniger sinnvoll finden.
Wofür du LDA im Marketing nutzt
Textquelle
Frage
Bewertungen
Was treibt schlechte Sterne?
Umfragen
Worüber schreiben Kunden frei?
Support-Tickets
Welche Themen gehören in die FAQ?
Blogs der Konkurrenz
Welche Themen fehlen bei dir?
LDA funktioniert am besten mit vielen, eher langen Texten. Bei sehr kurzen Texten wie Tweets oder Ein-Satz-Bewertungen stehen zu wenige Wörter in jedem Text. Dafür gibt es eigene Verfahren, und neuere Ansätze wie BERTopic kommen damit oft besser klar.
Häufige Fehler
Fehler 1 · LDA für einen Rankingfaktor halten
2010 meldete ein großer SEO-Softwareanbieter eine auffällig hohe Korrelation zwischen LDA-Werten und Google-Rankings. Die Zahl wurde kurz danach wegen eines Rechenfehlers nach unten korrigiert. Und Korrelation ist ohnehin keine Ursache. „LDA-Optimierung“ ist kein Hebel für dein Ranking.
Fehler 2 · Themen für fertige Etiketten halten
LDA liefert nur Wortlisten mit Gewichten. Ob „Paket, Tage, spät“ das Thema „Lieferzeit“ ist, entscheidest du. Die Benennung ist Handarbeit — und dabei passieren die meisten Fehlschlüsse.
Fehler 3 · Texte nicht vorbereiten
Ohne Aufräumen bekommst du Themen aus Füllwörtern wie „und“, „der“, „ist“. Stoppwörter raus, Wörter auf ihre Grundform bringen (Lemmatisierung) — gerade im Deutschen mit seinen vielen Wortformen.
Fehler 4 · Die Reihenfolge übersehen
LDA sieht Texte als Wortsack (Bag of Words). Ob „gut“ oder „nicht gut“ dastand, ist für LDA fast dasselbe: Beides enthält „gut“. Für Stimmung brauchst du eine Sentiment-Analyse.
So startest du
- Werkzeug: Python mit scikit-learn (LatentDirichletAllocation) oder gensim (LdaModel).
- Daten: mehrere hundert bis tausend Texte, je mindestens ein paar Sätze lang.
- Themenzahl: mehrere Werte testen, etwa 5, 10 und 20, und die Wortlisten lesen.
Häufige Fragen
Was ist der Unterschied zwischen LDA und Topic Modeling?
Topic Modeling ist der Oberbegriff für Verfahren, die Themen in Texten finden. LDA ist das klassische, statistische Verfahren darunter. Neuere Verfahren wie BERTopic arbeiten mit Embeddings.
Wie viele Themen soll ich einstellen?
Es gibt keinen festen Wert: scikit-learn startet mit 10, gensim mit 100. Teste mehrere Werte, schau auf Kohärenz-Maße und lies vor allem die Wortlisten selbst.
Funktioniert LDA mit kurzen Texten wie Social-Kommentaren?
Eher schlecht. In sehr kurzen Texten stehen zu wenige Wörter, um Themen sauber zu trennen. Für Tweets und Ein-Satz-Bewertungen sind andere Verfahren oft besser.
Ist LDA ein Google-Rankingfaktor?
Nein. Die Behauptung stammt aus einer Korrelationsstudie von 2010, deren Zahl kurz danach korrigiert wurde. Google hat LDA nie als Rankingfaktor bestätigt.
LDA oder BERTopic — was nehme ich?
LDA ist leicht, schnell und gut nachvollziehbar, braucht aber lange Texte und eine vorgegebene Themenzahl. BERTopic versteht Bedeutung besser und kommt mit kurzen Texten klarer, braucht aber mehr Rechenleistung.