

Was ist Topic Modeling?
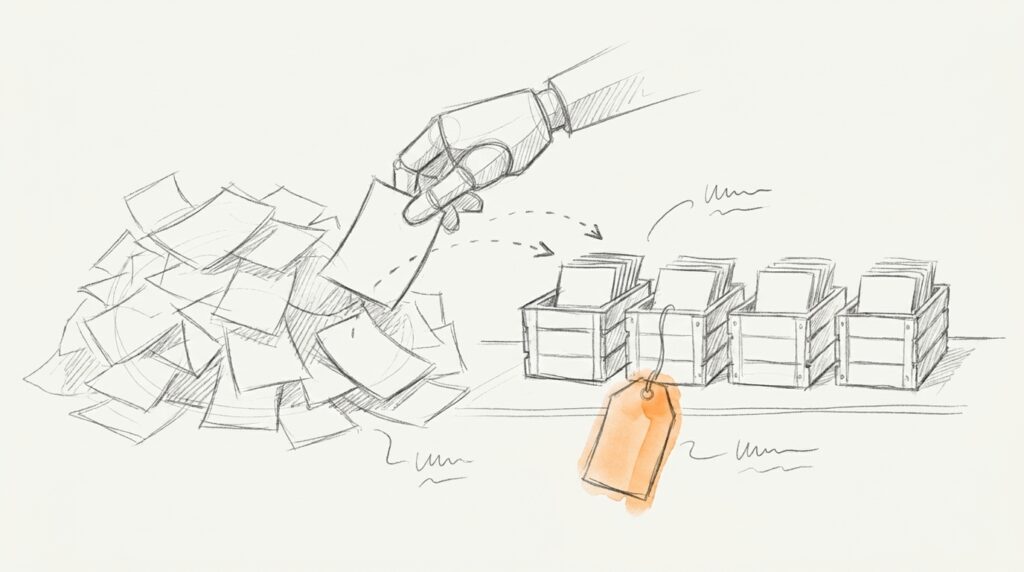
Stell dir einen Stapel mit tausend Kundenbewertungen vor. Du willst wissen, worüber die Leute schreiben. Lesen dauert Tage. Topic Modeling sortiert den Stapel in Minuten nach Themen — ohne dass du vorher sagst, welche Themen es geben soll.
Ein „Thema“ ist für die Maschine eine Gruppe von Wörtern, die häufig gemeinsam auftauchen. Zum Beispiel „Lieferung, Paket, Tage, spät“. Jeder Text bekommt dann einen Anteil an einem oder mehreren solcher Themen. Was das Thema bedeutet, muss am Ende ein Mensch sagen — hier offensichtlich: „Lieferzeit“.
Topic Modeling gehört zum Text Mining und arbeitet unüberwacht. Das heißt: Niemand bringt dem Modell vorher bei, was richtig ist. Es findet Muster allein aus den Daten.
Die wichtigsten Verfahren
- LDA (Latent Dirichlet Allocation): der Klassiker von Blei, Ng und Jordan aus 2003. Jedes Dokument ist eine Mischung aus Themen, jedes Thema eine Mischung aus Wörtern.
- NMF: ein mathematisch einfacheres Verfahren, das oft ähnlich gute Themen liefert.
- BERTopic: 2022 von Maarten Grootendorst vorgestellt. Übersetzt Texte per Sprachmodell in Embeddings, bildet daraus Gruppen und sucht die typischen Wörter jeder Gruppe.
- Mit Sprachmodellen: Ein LLM liest die Texte und beschreibt die Themen gleich in ganzen Sätzen.
Das LDA-Paper zeigt schön, wie die Arbeit verteilt ist: Die Autoren ließen ein Modell mit 100 Themen über 16.000 Nachrichtenartikel laufen. Die gefundenen Wortgruppen haben sie danach selbst benannt. Daran hat sich bis heute wenig geändert.
Die Sprachmodell-Variante holt auf. Beim Verfahren TopicGPT, vorgestellt 2024, stimmten die gefundenen Themen deutlich besser mit von Menschen vergebenen Themen überein: 0,74 gegenüber 0,64 beim besten Vergleichsverfahren, gemessen an Wikipedia-Artikeln.
Wofür du es im Marketing nutzt
Textquelle
Typische Frage
Bewertungen
Was loben, was bemängeln Kunden?
Support-Tickets
Welche Anliegen häufen sich?
Social Listening
Worüber wird zur Marke gesprochen?
Umfrage-Freitext
Was steckt hinter „Sonstiges“?
Eigener Blog
Welche Themen fehlen noch?
Ein frühes Beispiel aus der Marketing-Forschung: Tirunillai und Tellis werteten 2014 mit LDA Produktbewertungen von 15 Firmen aus fünf Märkten über vier Jahre aus. So fanden sie, welche Qualitätsmerkmale Kunden je Branche wichtig sind — ohne vorher eine Liste festzulegen.
Häufige Fehler
Fehler 1 · Die Themenzahl raten
Bei LDA gibst du die Zahl der Themen vor, bei BERTopic steuerst du sie über die Mindestgröße eines Themas. Zu wenige Themen werfen alles in einen Topf, zu viele zerfasern. Probier mehrere Werte aus und schau, welche Gruppen für dich Sinn ergeben.
Fehler 2 · Wortlisten für fertige Ergebnisse halten
Das Modell liefert Wortgruppen, keine Einsichten. „Preis, teuer, Euro, Angebot“ kann Lob oder Ärger sein. Lies zu jedem Thema ein paar Beispieltexte, bevor du Schlüsse ziehst.
Fehler 3 · Kurze Texte mit LDA auswerten
LDA zählt, welche Wörter zusammen vorkommen, und ignoriert ihre Reihenfolge. Bei Ein-Satz-Bewertungen oder Posts gibt es dafür zu wenig Material. Für kurze Texte passen BERTopic oder ein Sprachmodell besser.
Fehler 4 · Den Ausreißer-Topf mitzählen
BERTopic sammelt Texte, die nirgends passen, im Thema −1. Laut Dokumentation solltest du es in der Regel ignorieren. Wer es mitzählt, verfälscht die Anteile; wer es mit Gewalt leer drückt, verbiegt die Daten.
So fängst du an
- Ohne Code: Exportier die Texte und gib sie in Portionen an ChatGPT oder Claude mit dem Auftrag, wiederkehrende Themen mit Häufigkeit und Beispielzitat zu nennen.
- Mit Code: BERTopic in Python, mit mehrsprachigem Modell auch für deutsche Texte. Alternativ LDA und NMF in scikit-learn.
- Im Tool: Social-Listening- und Analyse-Tools wie Brandwatch oder MAXQDA bringen KI-gestützte Themenanalysen mit.
Häufige Fragen
Was ist der Unterschied zwischen Topic Modeling und Textklassifikation?
Bei der Textklassifikation stehen die Kategorien vorher fest, etwa „Lob“, „Beschwerde“, „Frage“. Das Modell sortiert nur ein. Topic Modeling findet die Gruppen selbst, ohne Vorgabe. Es eignet sich deshalb, wenn du noch nicht weißt, welche Themen es überhaupt gibt.
Wie viele Themen sollte ein Modell haben?
Eine richtige Zahl gibt es nicht. Sie hängt von der Textmenge und deiner Frage ab. Probier mehrere Einstellungen aus und nimm die, bei der sich die Themen klar benennen lassen und nicht überschneiden.
Ist LDA noch zeitgemäß?
Für lange Texte und große Mengen ja, es ist schnell und gut erforscht. Bei kurzen Texten wie Posts oder Ein-Satz-Bewertungen liefern BERTopic oder Sprachmodelle meist bessere Themen, weil sie die Bedeutung von Wörtern einbeziehen.
Funktioniert Topic Modeling mit deutschen Texten?
Ja. BERTopic bietet ein mehrsprachiges Modell für über 50 Sprachen, und große Sprachmodelle verstehen Deutsch ohnehin. Bei LDA solltest du Füllwörter wie „und“ oder „der“ vorher entfernen, sonst landen sie in jedem Thema.
Brauche ich Programmierkenntnisse?
Nicht unbedingt. Für ein paar hundert Texte reicht ein Sprachmodell mit gutem Auftrag. Für Tausende Texte, wiederholte Auswertungen oder saubere Zahlen lohnt sich ein Werkzeug wie BERTopic oder ein Analyse-Tool.


