Was ist BERTopic?
BERTopic ist eine Open-Source-Bibliothek für Python, mit der du Themen in großen Textmengen findest. Entwickelt hat sie Maarten Grootendorst, beschrieben ist sie in einem Paper von 2022. Die Bibliothek steht unter MIT-Lizenz, ist also kostenlos, und hat auf GitHub rund 8.000 Sterne (Stand November 2026).
Der Unterschied zum Klassiker Latent Dirichlet Allocation: LDA zählt Wörter. BERTopic arbeitet mit Embeddings, also Zahlenvektoren, die die Bedeutung eines Textes abbilden. „Paket kam zu spät“ und „Lieferung hat ewig gedauert“ landen so im selben Thema, obwohl sie kein Wort teilen.
So arbeitet BERTopic
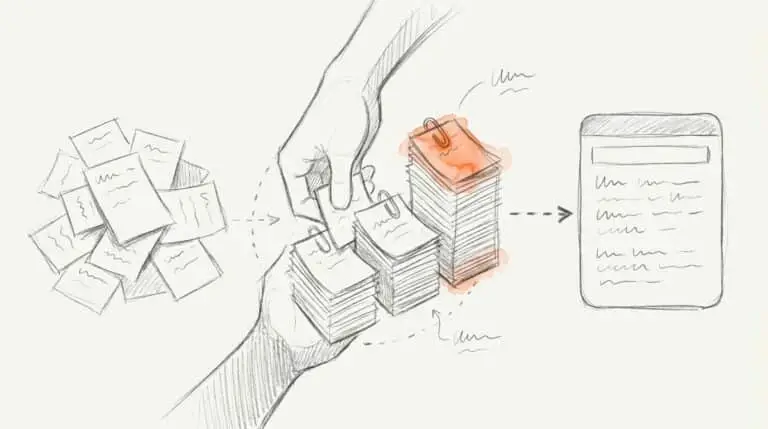
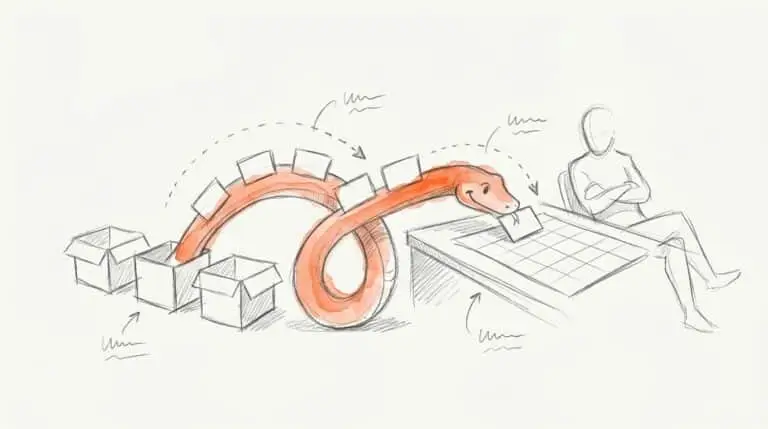
BERTopic ist ein Baukasten aus fünf Schritten. Jeder Baustein lässt sich austauschen:
- Embeddings: Jeder Text wird in einen Zahlenvektor umgewandelt.
- Verdichten (UMAP): Die vielen Dimensionen werden auf wenige reduziert.
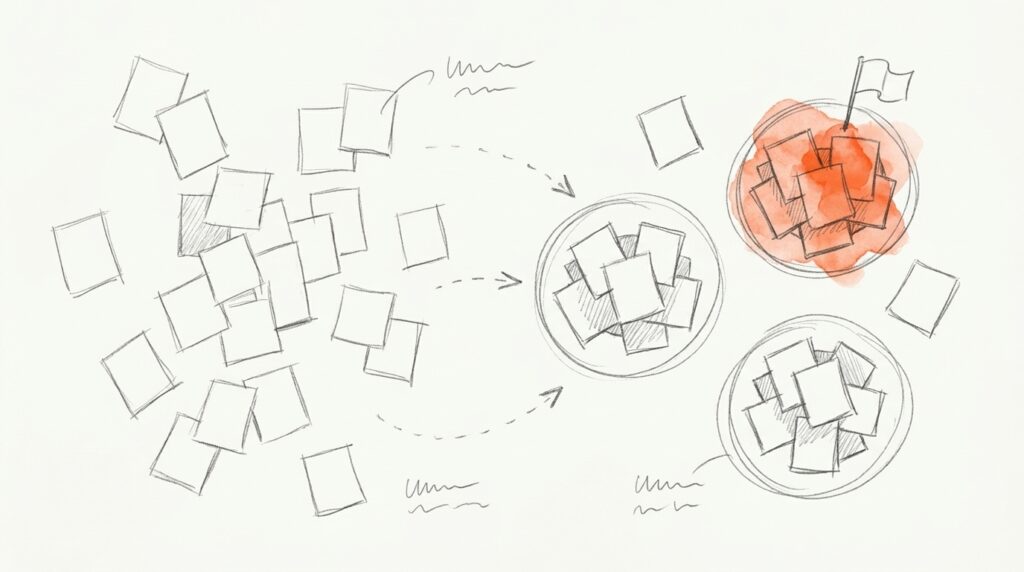
- Gruppieren (HDBSCAN): Ähnliche Texte bilden Cluster. Die Zahl der Themen ergibt sich dabei selbst. Texte, die nirgends passen, werden Ausreißer.
- Wörter zählen: Je Cluster werden alle Texte zusammengelegt und die Wörter gezählt.
- Beschreiben (c-TF-IDF): Wörter, die in einem Cluster häufig und in den anderen selten sind, beschreiben das Thema.
Optional lässt du ein Sprachmodell die Themen benennen, etwa über OpenAI oder lokal über Ollama. Dabei gehen standardmäßig nur die Stichwörter und vier typische Texte je Thema an das Modell — das spart Kosten.
Beispiele aus der Praxis
Studie · Bewertungen
Haushaltsgeräte, Korea (2023)
490.255
Bewertungen
57 %
als Ausreißer eingestuft
Gut die Hälfte landete im Ausreißer-Thema −1
Ein Forschungsteam mit LG Electronics sortierte Bewertungen aus fünf Produktgruppen. Ohne Nacharbeit bleibt bei kurzen Bewertungen viel Text unsortiert.
Benchmark · BBC News
2.225 Nachrichtenartikel
0,167
Kohärenz BERTopic
0,014
Kohärenz LDA
BERTopic mit deutlich zusammenhängenderen Themen
Eigener Vergleich des Autors aus dem Paper von 2022. LDA lief dort mit Standardwerten — ein Heimspiel, aber eine klare Tendenz.
Typische Einsätze im Marketing: Freitexte aus Kundenumfragen, Support-Tickets für die FAQ, Kommentare unter Social-Posts oder Suchanfragen für das Keyword-Clustering.
Häufige Fehler
Fehler 1 · Thema −1 für ein Thema halten
Laut Doku ist −1 kein Thema, sondern die Sammelstelle für Ausreißer. Mit der Funktion reduce_outliers verteilst du sie nachträglich auf die übrigen Themen.
Fehler 2 · Gleiche Ergebnisse bei jedem Lauf erwarten
UMAP arbeitet mit Zufall. Zweimal starten heißt zwei leicht andere Ergebnisse. Wer vergleichbare Zahlen will, setzt einen festen random_state — das kostet etwas Tempo.
Fehler 3 · Zu wenig Texte
Bei rund 1.000 Texten entstehen laut FAQ oft zu wenige Themen. Mit 200 Bewertungen findest du eher Rauschen als Muster.
Fehler 4 · Mehrere Themen pro Text erwarten
Das Paper sagt selbst: BERTopic nimmt an, dass jeder Text nur ein Thema hat. Eine Bewertung über Preis und Lieferung landet in einem Topf. Wer Mischungen braucht, muss das extra einschalten.
So startest du
- Installation: pip install bertopic, ab Python 3.10. Eine Grafikkarte hilft, ohne geht es deutlich langsamer.
- Umgebung: Jupyter oder Google Colab reichen für den Anfang.
- Deutsch: das mehrsprachige Modell wählen und deutsche Stoppwörter selbst ergänzen.
- Version: Die stabile Version ist 0.17.4, eine Beta der 1.0 mit neuem Standardmodell läuft seit November 2026.
Häufige Fragen
Ist BERTopic kostenlos?
Ja, die Bibliothek steht unter MIT-Lizenz. Kosten entstehen höchstens für Rechenleistung oder wenn du ein kostenpflichtiges Sprachmodell zum Benennen der Themen nutzt.
Funktioniert BERTopic mit deutschen Texten?
Ja. Das mehrsprachige Standardmodell kann über 50 Sprachen, darunter Deutsch. Stoppwörter für die Themenbeschreibung musst du selbst setzen.
Was bedeutet das Thema −1?
Das ist kein Thema, sondern die Sammelstelle für Texte, die in keine Gruppe passen. Mit reduce_outliers lassen sie sich nachträglich zuordnen.
Brauche ich Programmierkenntnisse?
Ja, Grundlagen in Python. Mit fertigen Beispielen aus der Doku und einem Colab-Notebook kommst du aber auch als Einsteiger in ein, zwei Stunden zu ersten Themen.
Was ist besser, BERTopic oder LDA?
Für kurze Texte und Bedeutung meist BERTopic, für schnelle, nachvollziehbare Auswertungen langer Texte oft LDA. LDA rechnet schneller, BERTopic findet die Themenzahl selbst.