Was ist der p-Wert?
Dein A/B-Test meldet: Variante B konvertiert besser, p = 0,03. Heißt das, B gewinnt mit 97 % Wahrscheinlichkeit? Nein. Und genau da fängt das Missverständnis an.
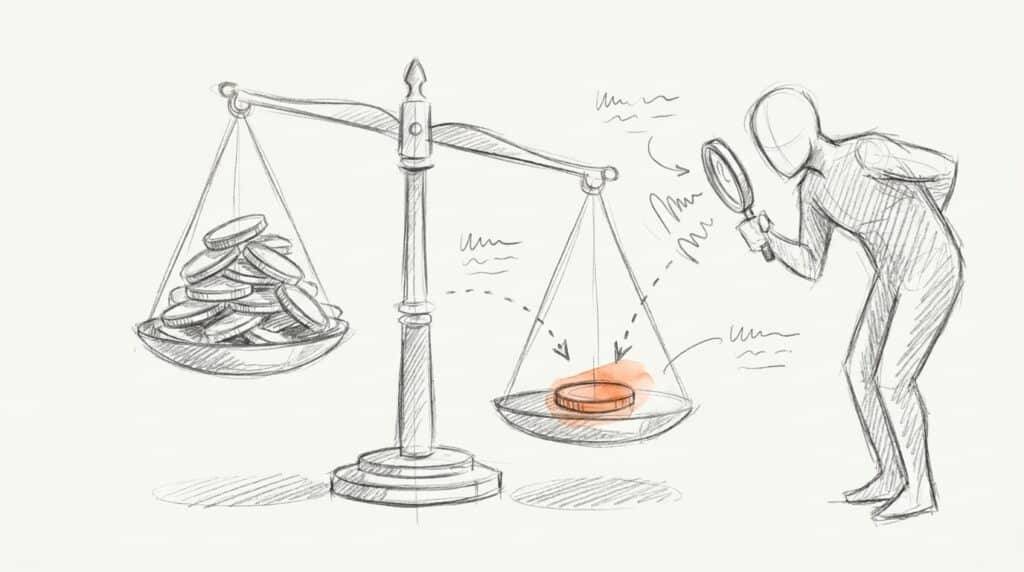
Der p-Wert beantwortet eine Frage um die Ecke: Angenommen, A und B wären in Wahrheit gleich gut — wie wahrscheinlich wäre dann ein Unterschied, der mindestens so groß ist wie der gemessene? Die Annahme „kein Unterschied“ heißt in der Statistik Nullhypothese.
- Kleiner p-Wert (z. B. 0,01): Dein Ergebnis wäre bei „kein Unterschied“ ziemlich überraschend.
- Großer p-Wert (z. B. 0,5): Dein Ergebnis passt gut zu bloßem Zufall.
Ist der p-Wert kleiner als eine vorher festgelegte Grenze, gilt das Ergebnis als statistisch signifikant. Diese Grenze heißt Signifikanzniveau, meist 0,05.
Ein Beispiel zum Mitrechnen
Derselbe Unterschied, zwei verschiedene Tests. Variante A konvertiert mit 5,0 %, Variante B mit 5,7 % — ein Plus von 14 %.
Test 1 · viel Traffic
10.000 Besucher je Variante
500 / 570
Conversions A / B
0,03
p-Wert
Unter 0,05 → signifikant
Ein Unterschied dieser Größe wäre bei reinem Zufall selten.
Test 2 · wenig Traffic
1.000 Besucher je Variante
50 / 57
Conversions A / B
0,49
p-Wert
Weit über 0,05 → nicht signifikant
Gleiche Raten, aber die Stichprobe ist zu klein. Der Unterschied kann trotzdem echt sein.
Gerechnet ist das vereinfacht mit dem gängigen z-Test für zwei Anteile, zweiseitig. Die Lehre: Der p-Wert hängt nicht nur am Unterschied, sondern stark an der Menge der Daten. Wie viele Besucher du brauchst, steht beim Begriff Statistische Power.
Was der p-Wert nicht sagt
2016 sah sich die American Statistical Association genötigt, zum ersten Mal überhaupt eine offizielle Stellungnahme zu einer Statistik-Methode herauszugeben — zum p-Wert. Die wichtigsten ihrer sechs Grundsätze, auf Marketing übersetzt:
- Der p-Wert misst nicht, wie wahrscheinlich deine Variante besser ist.
- Er misst nicht, wie groß oder wie wichtig der Effekt ist.
- Entscheidungen sollten nicht nur daran hängen, ob er unter einer Grenze liegt.
- Für sich allein ist er kein gutes Maß dafür, wie stark ein Beleg ist.
2019 gingen Forscher in der Fachzeitschrift Nature noch weiter und forderten, „statistisch signifikant“ nicht mehr als Ja-Nein-Schalter zu benutzen. Mehr als 800 Fachleute unterschrieben.
Häufige Fehler
Fehler 1 · p = 0,03 als „97 % Gewinnchance“ lesen
Das ist die häufigste Fehldeutung überhaupt. Eine echte Gewinnwahrscheinlichkeit liefern nur bayessche Verfahren — genau deshalb zeigen Tools wie VWO oder AB Tasty standardmäßig „Chance to win“ statt eines p-Werts.
Fehler 2 · „Nicht signifikant“ für „kein Effekt“ halten
Test 2 oben zeigt es: Der Unterschied war genauso groß, nur die Stichprobe zu klein. „Nicht signifikant“ heißt „nicht gezeigt“, nicht „widerlegt“.
Fehler 3 · Kleinen p-Wert mit großem Effekt verwechseln
Bei viel Traffic wird jeder Krümel signifikant. Ein Plus von 0,05 Prozentpunkten kann p = 0,001 haben und trotzdem den Umbau nicht wert sein. Schau immer auf die Größe des Unterschieds.
Fehler 4 · Zwischendurch reinschauen und abbrechen
Wer täglich nachsieht und stoppt, sobald p unter 0,05 rutscht, betrügt sich selbst. Der Statistiker Evan Miller zeigt an einem Beispiel: Aus geplanten 5 % Fehlalarmen werden so 26,1 %. Optimizely meldet aus eigenen Simulationen sogar über 25 %. Genauso schlimm: so lange Segmente und Kennzahlen durchprobieren, bis irgendwo ein kleiner p-Wert auftaucht. Das nennt man p-Hacking.
So gehst du richtig damit um
- Vorher festlegen: Grenze, Hauptkennzahl und benötigte Besucherzahl — und erst dann starten.
- Durchlaufen lassen: Erst am geplanten Ende auswerten, mindestens eine volle Woche.
- Effekt mitlesen: Wie groß ist der Unterschied, wie breit ist das Konfidenzintervall, lohnt sich das wirtschaftlich?
- Tool verstehen: Optimizely testet sequenziell und erlaubt Zwischenblicke, VWO und AB Tasty arbeiten bayessch. Google Optimize ist seit dem 30. September 2023 eingestellt; GA4 hat kein eigenes A/B-Testing.
Häufige Fragen
Was sagt ein p-Wert von 0,05 genau aus?
Wäre zwischen A und B in Wahrheit kein Unterschied, würdest du einen mindestens so deutlichen Unterschied wie gemessen in etwa 5 % der Fälle allein durch Zufall sehen. Mehr nicht — vor allem keine Gewinnwahrscheinlichkeit.
Warum gerade 0,05 als Grenze?
Weil der Statistiker Ronald Fisher sie 1925 als bequeme Grenze vorschlug. Es ist eine Konvention. In vielen A/B-Tools kannst du die Grenze selbst einstellen — strenger für teure Entscheidungen, lockerer für schnelle Experimente.
Heißt ein kleiner p-Wert, dass meine Variante sicher besser ist?
Nein. Er heißt nur, dass dein Ergebnis zu „kein Unterschied“ schlecht passt. Ob der Effekt groß genug ist und sich wiederholt, sagt er nicht. Zufallstreffer gibt es auch bei kleinen p-Werten.
Darf ich während eines A/B-Tests auf die Ergebnisse schauen?
Schauen schon, entscheiden nicht — zumindest bei klassischen Tests mit festem Ende. Wer beim ersten kleinen p-Wert abbricht, vervielfacht die Fehlalarme. Tools mit sequenziellem oder bayesschem Verfahren sind für Zwischenblicke gebaut.
Warum zeigt mein Tool keinen p-Wert an?
Weil es bayessch rechnet, etwa VWO mit SmartStats oder AB Tasty. Statt des p-Werts siehst du eine Wahrscheinlichkeit, dass eine Variante besser ist. Das ist für Entscheidungen oft sogar verständlicher.