Was ist Context Rot?
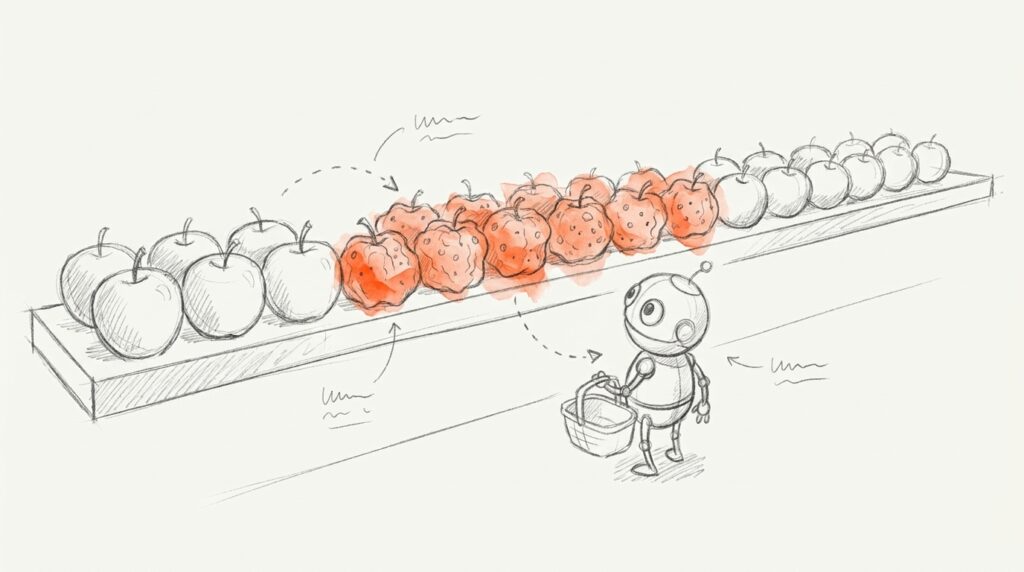
Kennst du das? Am Anfang des Chats hast du der KI genau gesagt: Du-Form, kurze Sätze, Zielgruppe Handwerksbetriebe. Drei Stunden und zwanzig Entwürfe später schreibt sie plötzlich im Sie und holt Formulierungen aus Version zwei zurück. Das nennt man Context Rot, auf Deutsch etwa Kontextverfall.
Gemeint ist: Ein Sprachmodell arbeitet schlechter, je mehr Text in seinem Kontext steht. Anthropic schreibt dazu in der eigenen Doku ganz offen, dass mehr Kontext nicht automatisch besser ist — mit wachsender Tokenzahl sinken Genauigkeit und Erinnerung. Ein Token ist ein Textstück, grob ein Wortteil.
Bekannt gemacht hat den Begriff ein Bericht von Chroma vom Juli 2025. Wer ihn zuerst benutzt hat, ist nicht geklärt.
Was die Forschung zeigt
Chroma hat 18 Modelle von Anthropic, OpenAI, Google und Alibaba getestet, mit fast 195.000 Aufrufen. Das Ergebnis war eindeutig: In allen Experimenten sank die Leistung, je länger die Eingabe wurde. Schon eine einzige ähnliche, aber falsche Information im Text verschlechterte das Ergebnis.
Dazu kommt ein älterer Befund mit dem schönen Namen Lost in the Middle (Liu und andere, 2023): Modelle nutzen Informationen am Anfang und am Ende des Kontexts am besten, in der Mitte am schlechtesten. Im Test mit vielen Dokumenten fiel GPT-3.5-Turbo im schlechtesten Fall sogar unter den Wert, den es ganz ohne Dokumente erreichte.
Studie
Befund
NoLiMa (2025)
11 von 13 Modellen bei 32.000 Tokens unter der Hälfte ihres Kurztext-Werts
RULER (2024)
nur die Hälfte von 17 Modellen bei 32.000 Tokens noch zufriedenstellend
Chroma (2025)
Leistung sinkt bei allen 18 Modellen mit der Länge
NoLiMa und RULER sind begutachtete Konferenz-Paper. Getestet wurden Modelle von 2023 bis 2025; neuere Modelle sind teils besser, das Grundproblem nennt Anthropic aber auch in der aktuellen Doku.
Beispiele aus der Praxis
Wie groß der Unterschied sein kann, zeigt ein Test aus dem Chroma-Bericht. Die Frage war jeweils dieselbe, nur der mitgegebene Text war verschieden lang.
Fall A · Langer Chatverlauf
Ganzer Verlauf gegen das Wesentliche
≈ 113.000
Tokens mit ganzem Verlauf
≈ 300
Tokens nur mit dem Relevanten
Alle Modelle antworteten mit dem kurzen, fokussierten Text deutlich besser.
Chroma, Test LongMemEval mit 306 Fragen, 2025. Bei Claude war der Abstand am größten — vor allem, weil Claude bei Unklarheit lieber gar nicht antwortet.
Fall B · Großes Briefing
Die eine wichtige Zeile in der Mitte
> 20 %
Leistungsabfall je nach Position
20–30
Dokumente im schlechtesten Fall
Steht die entscheidende Info in der Mitte eines langen Stapels, geht sie am ehesten unter.
Lost in the Middle, GPT-3.5-Turbo im Test mit mehreren Dokumenten (TACL 2024). Übertragen auf dein Briefing: 40 Seiten Styleguide plus Wettbewerber-PDFs, und die Preisvorgabe steht auf Seite 19.
Häufige Fehler
Fehler 1 · Großes Fenster mit gutem Gedächtnis verwechseln
„Das Modell schafft eine Million Tokens, also nutzt es auch alles.“ Stimmt nicht. Schon die Lost-in-the-Middle-Studie fand, dass Modelle mit erweitertem Fenster oft nicht besser abschneiden als ihre kürzeren Geschwister. Platz ist nicht gleich Aufmerksamkeit.
Fehler 2 · Einen Chat ewig weiterführen
Ein Chat für Newsletter, Ads und Blog über drei Tage: Alte Entwürfe, verworfene Ideen und Nebenfragen bleiben alle im Kontext. Jeder davon wirkt wie ein Ablenker — und schon einer schadet laut Chroma messbar.
Fehler 3 · Alles ungefiltert reinkippen
Drei Versionen desselben Styleguides, das komplette Interview-Transkript, fünf ähnliche Wettbewerber-Texte. Mehr Material fühlt sich gründlich an, macht das Ergebnis aber oft schlechter. Wähl aus, bevor du hochlädst.
Fehler 4 · Die wichtigste Vorgabe in die Mitte stellen
Was zählt, gehört an den Anfang oder ans Ende deines Prompts. Ein Satz wie „Wichtig: keine Preise nennen“ mitten in Absatz sieben ist genau die Stelle, an der Modelle am schlechtesten hinschauen.
Was hilft gegen Context Rot?
Anthropic nennt die Disziplin dahinter Context Engineering: das Ziel ist die kleinstmögliche Menge an wirklich aussagekräftigen Tokens. Für den Alltag heißt das:
- Neuer Chat je Aufgabe: mit einer kurzen Übergabe-Zusammenfassung aus dem alten.
- Zusammenfassen statt mitschleppen: Viele Tools komprimieren lange Verläufe inzwischen selbst.
- Projekte und Notizen nutzen: Feste Vorgaben gehören in Projekt-Anweisungen oder ein Memory, nicht in Nachricht 1 von 80.
- Nur das Relevante laden: Ausschnitte statt ganzer Dokumente, wie es RAG automatisch macht.
- Wichtiges an die Ränder: Zielgruppe, Ton und Tabus an den Anfang, die Aufgabe ans Ende.
Häufige Fragen
Ab wie vielen Tokens beginnt Context Rot?
Eine feste Schwelle gibt es nicht, es hängt von Modell und Aufgabe ab. In der NoLiMa-Studie fielen aber schon bei 32.000 Tokens 11 von 13 Modellen unter die Hälfte ihres Werts bei kurzen Texten.
Hilft ein größeres Kontextfenster gegen Context Rot?
Nein. Ein größeres Fenster heißt nur, dass mehr hineinpasst. Studien wie RULER und Lost in the Middle zeigen, dass Modelle den zusätzlichen Platz nicht automatisch gut nutzen.
Woran merke ich Context Rot im Chat?
Frühe Vorgaben zu Ton oder Zielgruppe werden vergessen, alte Versionen tauchen wieder auf, Antworten werden ungenauer oder widersprüchlich. Dann ist ein neuer Chat mit Zusammenfassung meist der schnellste Weg.
Was ist der Unterschied zu Lost in the Middle?
Lost in the Middle beschreibt einen Teil des Problems: Informationen in der Mitte eines langen Kontexts werden am schlechtesten genutzt. Context Rot ist der Oberbegriff dafür, dass die Leistung mit der Länge insgesamt sinkt.
Haben neue Modelle das Problem noch?
Neuere Modelle kommen mit langen Texten besser zurecht, gelöst ist das Problem aber nicht. Anthropic beschreibt Context Rot auch in der aktuellen Doku als bestehenden Effekt.


