

Was sind Fehler 1. und 2. Art?
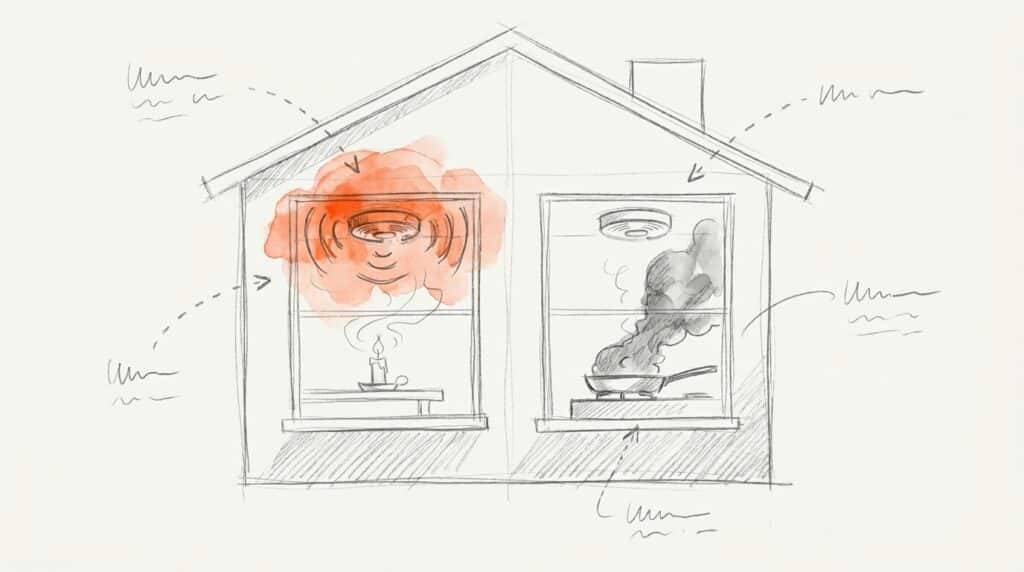
Ein Rauchmelder kann auf zwei Arten versagen. Er piept, weil jemand eine Kerze anzündet. Oder er bleibt stumm, obwohl die Pfanne qualmt. Genau diese zwei Fehler kennt auch jeder statistische Test, also auch dein A/B-Test.
- Fehler 1. Art (Alpha-Fehler): Der Test meldet einen Gewinner, obwohl die Variante nichts bewirkt. Ein Fehlalarm, auch falsch positiv genannt.
- Fehler 2. Art (Beta-Fehler): Die Variante ist wirklich besser, aber der Test endet „ohne Ergebnis“. Ein übersehener Treffer, falsch negativ.
Das Konzept geht auf die Statistiker Jerzy Neyman und Egon Pearson zurück, 1928. In der Qualitätssicherung heißen dieselben Fehler Produzenten- und Konsumentenrisiko.
Warum 5 % Fehlalarm nicht 5 % falsche Gewinner heißt
Hier stolpern fast alle. α = 5 % heißt: Wenn eine Variante nichts bewirkt, meldet der Test in 5 von 100 Fällen trotzdem einen Gewinner. Es heißt nicht, dass 95 % deiner Gewinner echt sind.
Wie viele Gewinner Nieten sind, hängt davon ab, wie viele deiner Ideen überhaupt etwas taugen. Ronny Kohavi und Kollegen haben das für große Testplattformen geschätzt, bei 80 % Power und 5 % Signifikanz:
Erfolgsquote der Ideen
Falsche Gewinner
33 % (Microsoft)
5,9 %
15 % (Bing)
15,0 %
10 % (u. a. Booking.com)
22,0 %
8 % (Airbnb-Suche)
26,4 %
Die Erfolgsquoten sind grobe Schätzungen der Autoren. Die Botschaft ist trotzdem klar: Je seltener eine Idee wirklich wirkt, desto mehr Fehlalarme stecken unter deinen Gewinnern.
Beispiele aus der Praxis
Case A · Studie mit Optimizely-Daten
2.766 Experimente, 4.964 Effekte
≈ 70 %
Ideen ohne Wirkung
18–25 %
falsche Gewinner bei 5 %
Etwa jeder fünfte Gewinner wirkt im Live-Betrieb nicht
Berman und Van den Bulte, Management Science 2021. Bei 10 % Signifikanz waren es sogar 28–37 %.
Case B · Zu früh gestoppt
2.101 Optimizely-Experimente
57 %
stoppen bei 90 % Konfidenz
33 → 42 %
falsche Gewinner
Frühes Stoppen hebt den Anteil der Nieten um ein Viertel
Arbeitspapier von Berman, Pekelis, Scott und Van den Bulte, 2018. Wer beim ersten Signal stoppt, macht mehr Fehler 1. Art.
Häufige Fehler
Fehler 1 · Signifikanz als Gewinnwahrscheinlichkeit lesen
„90 % Signifikanz, also 90 % sicher“ — falsch. Der p-Wert rechnet unter der Annahme, dass es keinen Effekt gibt. Er sagt nicht, wie wahrscheinlich dein Gewinner echt ist. Das zeigt die Tabelle oben.
Fehler 2 · Zwischendurch reinschauen und stoppen
Wer bei 5 % Signifikanz laufend nachschaut und beim ersten Treffer aufhört, landet in Evan Millers Simulation bei 26,1 % Fehlalarmen. Das nennt sich Peeking. Leg Laufzeit und Besucherzahl vorher fest.
Fehler 3 · Viele Kennzahlen ohne Korrektur
Jede weitere Kennzahl, Variante und jedes Segment ist eine neue Chance auf einen Fehlalarm. GrowthBook rechnet vor: 10 Experimente mit 2 Varianten und 10 Kennzahlen sind 100 Tests gleichzeitig. Tools wie GrowthBook bieten dafür Korrekturen an.
Fehler 4 · Den Fehler 2. Art vergessen
Ein Test „ohne Ergebnis“ beweist nicht, dass die Idee nichts taugt. Vielleicht war er nur zu klein. In der Optimizely-Studie lag die Power im Schnitt bei 65–70 %, also wurde rund jeder dritte echte Effekt übersehen.
Was du daraus machst
- Kosten abwägen: Ein falscher Rollout kostet Umsatz, eine übersehene Chance auch. Was teurer ist, bestimmt dein Niveau.
- Vorher planen: Signifikanz, Power und Minimum Detectable Effect festlegen, Besucherzahl ausrechnen.
- Eine Hauptkennzahl: Vor dem Start bestimmen, an welcher Zahl du entscheidest.
- Gewinner nachprüfen: Wichtige Ergebnisse mit einem zweiten Test bestätigen, bevor du groß umbaust.
Häufige Fragen
Was ist der Unterschied zwischen Fehler 1. und 2. Art?
Fehler 1. Art: Der Test meldet einen Effekt, den es nicht gibt (Fehlalarm). Fehler 2. Art: Der Test übersieht einen Effekt, den es gibt. Eselsbrücke: Der erste ruft „Feuer“ ohne Feuer, der zweite schweigt, während es brennt.
Welcher Fehler ist schlimmer?
Das hängt von den Kosten ab. Rollst du eine teure Änderung auf Basis eines Fehlalarms aus, ist der Fehler 1. Art schlimmer. Verpasst du eine große Chance, wiegt der Fehler 2. Art schwerer. Das legst du über Signifikanzniveau und Power fest.
Kann ich beide Fehler gleichzeitig senken?
Ja, aber nur mit mehr Daten. Bei gleicher Besucherzahl steigt der eine Fehler, wenn du den anderen senkst. Mehr Traffic oder ein größerer gesuchter Effekt verbessern beides.
Warum nimmt man 5 % als Signifikanzniveau?
Es ist eine verbreitete Konvention, keine Naturkonstante. Im Marketing sind auch 10 % üblich, Google Ads stellt bei Experimenten sogar 80 % Konfidenz ein. Je niedriger die Hürde, desto mehr Fehlalarme.
Was bedeutet eine Power von 80 %?
Gibt es einen echten Effekt in der geplanten Größe, findet ihn der Test in 80 von 100 Fällen. In 20 Fällen übersieht er ihn — das ist der Fehler 2. Art, β = 20 %.


