

Was ist Self-Attention?
Nimm den Satz „Die Bank am Fluss war nass.“ Du weißt sofort: Gemeint ist eine Sitzbank, keine Sparkasse. Das Wort „Fluss“ verrät es. Ein Sprachmodell braucht dafür einen Mechanismus, und der heißt Self-Attention.
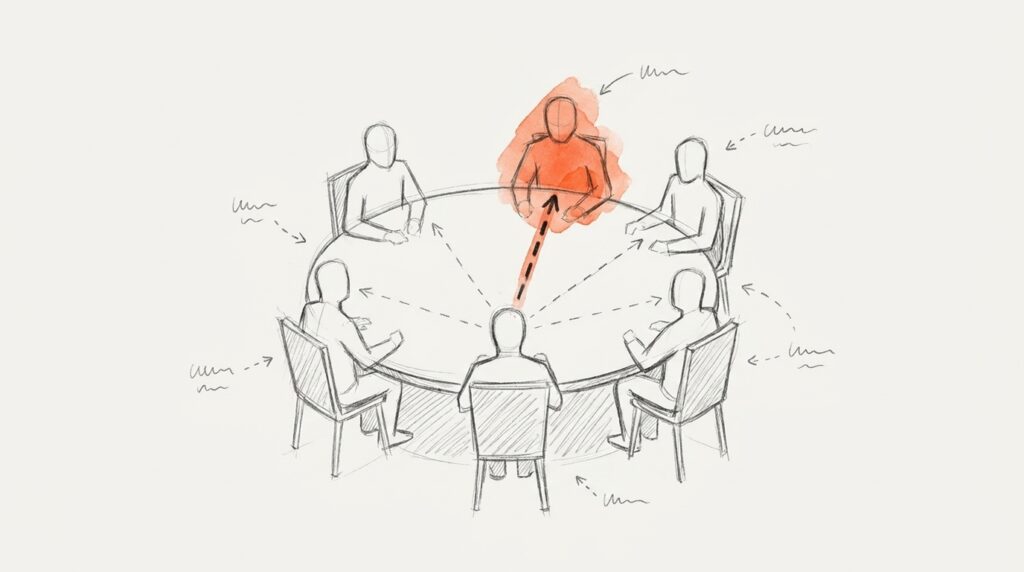
Bei Self-Attention schaut jedes Wort auf alle anderen Wörter desselben Textes und gewichtet, wie wichtig sie für seine eigene Bedeutung sind. „Bank“ schaut stark auf „Fluss“, kaum auf „war“. So entsteht für jedes Wort eine Bedeutung, die den ganzen Satz einbezieht.
Vorgestellt wurde der Mechanismus in dieser Form 2017 von einem Google-Team im Fachartikel „Attention Is All You Need“. Die Autoren definieren Self-Attention als Mechanismus, der „verschiedene Positionen einer einzelnen Sequenz“ zueinander in Beziehung setzt. Darauf baut die gesamte Architektur des Transformers auf.
Query, Key und Value ohne Mathe
Im Fachartikel arbeitet Self-Attention mit drei Rollen für jedes Wort. Stell dir eine Bibliothek vor:
- Query ist die Suchanfrage: „Was suche ich, um mich zu verstehen?“
- Key ist die Karteikarte jedes Wortes: „Wofür bin ich relevant?“
- Value ist das Buch selbst: „Das steuere ich bei.“
Passt die Query eines Wortes gut zum Key eines anderen, fließt viel von dessen Value in die neue Bedeutung ein. Das passiert für alle Wortpaare gleichzeitig.
Multi-Head Attention heißt: Das Ganze läuft mehrfach parallel, mit verschiedenen Blickwinkeln. Das Basismodell von 2017 hatte acht solcher Köpfe. Ein Kopf achtet etwa auf Grammatik, ein anderer darauf, worauf sich „sie“ bezieht. Forscher haben in BERT Köpfe gefunden, die sehr genau das Objekt eines Verbs oder solche Rückbezüge erfassen.
Was das für deine Arbeit mit KI heißt
Erstens: Lange Texte kosten Rechenkraft. Wenn jedes Wort auf jedes andere schaut, wächst der Aufwand quadratisch mit der Textlänge. Doppelt so viel Text heißt vierfache Arbeit im Attention-Teil. Bei 1.000 Tokens sind das eine Million Paare, bei 100.000 Tokens zehn Milliarden — je Kopf und Schicht. Das ist der Grund, warum Kontextfenster begrenzt sind.
Für deine Rechnung heißt das aber nicht automatisch quadratische Preise. Anthropic etwa berechnet bei seinen aktuellen großen Modellen auch sehr lange Anfragen zum selben Preis pro Token (Stand November 2026). Teuer wird es trotzdem, weil jedes Token zählt, oft bei jeder Anfrage aufs Neue.
Zweitens: Die Mitte geht unter. Eine Studie von Liu und Kollegen zeigte 2023 eine U-förmige Kurve: Sprachmodelle nutzen Informationen am Anfang und am Ende langer Texte am besten. Steht das Wichtige in der Mitte, sinkt die Leistung deutlich, um teils mehr als 20 %. Neuere Modelle mildern das ab, das Muster ist aber bekannt.
Case A · Google-Suche
BERT versteht Suchanfragen
1 von 10
englischen US-Suchen 2019
fast alle
englischen Suchen 2020
„to“ in „brazil traveler to usa“ wird endlich verstanden
BERT baut auf Self-Attention auf und liest ein Wort mit allem davor und danach.
Case B · Lange Prompts
Lost in the Middle
56,1 %
richtig ganz ohne Dokumente
20 %+
Abfall bei Info in der Mitte
Mit Info in der Mitte teils schlechter als ohne
GPT-3.5-Turbo in der Studie von Liu et al. 2023, Frage-Antwort über 20 bis 30 Dokumente.
Häufige Fehler
Fehler 1 · Großes Kontextfenster heißt, alles wird gelesen
Ein Modell kann viel aufnehmen, nutzt aber nicht alles gleich gut. Die Lost-in-the-Middle-Studie fand, dass Modelle mit größerem Fenster den Kontext nicht unbedingt besser nutzen. Mehr reinkippen ist keine Strategie.
Fehler 2 · Attention als Begründung lesen
Werkzeuge wie BertViz zeigen hübsch, welches Wort auf welches schaut. Eine Erklärung, warum das Modell so entscheidet, ist das nicht. Jain und Wallace zeigten 2019, dass sehr unterschiedliche Attention-Muster zur gleichen Antwort führen können.
Fehler 3 · BERT mit ChatGPT gleichsetzen
Beide nutzen Self-Attention, aber unterschiedlich. BERT liest in beide Richtungen und versteht Text, schreibt aber keinen. GPT-Modelle schauen nur nach links, auf das bisher Geschriebene, und erzeugen daraus das nächste Wort.
So schreibst du Prompts, die ankommen
- Auftrag an den Anfang: Was du willst, gehört nach oben — und bei langen Texten am Ende noch einmal kurz wiederholt.
- Material vorsortieren: Lieber fünf passende Quellen als fünfzig ungeprüfte. Genau das macht auch RAG.
- Klar beziehen: Eindeutige Namen statt „das oben Genannte“. Je klarer der Bezug, desto leichter hat es die Attention.
Häufige Fragen
Was ist der Unterschied zwischen Attention und Self-Attention?
Attention ist der allgemeine Mechanismus, mit dem ein Modell Teile einer Eingabe gewichtet. Bei Self-Attention schaut ein Text auf sich selbst, jedes Wort auf alle anderen. Bei Cross-Attention schaut ein Text auf einen anderen, zum Beispiel die Übersetzung auf das Original.
Warum sind lange Texte für KI aufwendig?
Weil bei Self-Attention jedes Token mit jedem anderen verglichen wird. Der Aufwand dafür wächst quadratisch mit der Länge. Tricks wie FlashAttention rechnen das schneller, ändern aber nichts am Grundprinzip.
Wo sollte die wichtigste Information im Prompt stehen?
Am Anfang oder am Ende. Studien zeigen, dass Sprachmodelle die Mitte langer Texte schlechter nutzen. Bei langen Dokumenten hilft es, die Frage ans Ende zu stellen und den wichtigen Abschnitt ausdrücklich zu benennen.
Hat Self-Attention etwas mit SEO zu tun?
Indirekt. Google nutzt seit 2019 BERT, ein Modell mit Self-Attention, um Suchanfragen im Zusammenhang zu verstehen. Optimieren lässt sich darauf nicht direkt. Klare, natürliche Sätze, die echte Fragen beantworten, sind der beste Weg.
Kann ich sehen, worauf ein Modell achtet?
Teilweise. Das Open-Source-Werkzeug BertViz zeigt die Attention-Gewichte von Modellen wie BERT und GPT-2 als Grafik. Das ist ein spannender Einblick, aber keine verlässliche Erklärung für die Entscheidung des Modells.


