Was ist ein Tokenizer?
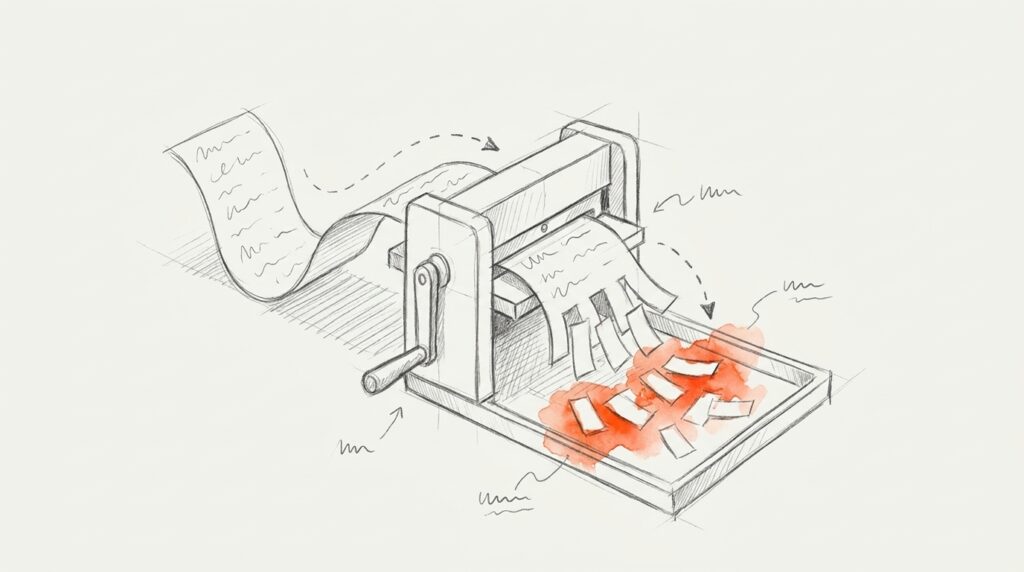
Ein Sprachmodell liest keine Buchstaben und keine Wörter. Es liest Zahlen. Der Tokenizer ist das Werkzeug davor: Er zerlegt deinen Text in kleine Stücke, die Tokens, und gibt jedem Stück eine Nummer aus einem festen Vokabular. Bei der Antwort läuft es rückwärts, aus Nummern wird wieder Text.
Ein Token kann ein ganzes Wort sein, ein Wortteil, ein Satzzeichen oder ein einzelnes Byte. Häufige Wörter bekommen ein eigenes Token, seltene werden in Teile zerlegt. OpenAI beschreibt seinen Tokenizer als umkehrbar und verlustfrei: Aus den Nummern lässt sich der Text exakt wiederherstellen.
Wie ein Tokenizer schneidet
Die meisten aktuellen Modelle nutzen ein Verfahren namens Byte-Pair-Encoding (BPE). Es startet mit einzelnen Zeichen. Dann fügt es immer das häufigste benachbarte Paar zu einem neuen Token zusammen, wieder und wieder, bis das Vokabular die gewünschte Größe hat. In der Sprachverarbeitung bekannt wurde BPE 2016 durch eine Arbeit zur maschinellen Übersetzung, getestet unter anderem an Englisch und Deutsch.
Wie groß das Vokabular ist, unterscheidet sich je Modell:
Tokenizer
Vokabular
GPT-2 (OpenAI)
50.257 Tokens
cl100k_base (GPT-4)
rund 100.000
o200k_base (GPT-4o bis GPT-5)
rund 200.000
Gemma 3 (Google)
rund 256.000
Ein größeres Vokabular kann mehr ganze Wörter und Wortteile abbilden, auch aus anderen Sprachen. Googles SentencePiece arbeitet direkt mit Rohtext und behandelt das Leerzeichen als eigenes Zeichen, Gemma nutzt es. Als Faustregel nennt Google für Englisch: Ein Token entspricht etwa vier Zeichen.
Warum Deutsch mehr Tokens braucht
Tokenizer werden mit riesigen Textmengen trainiert, und die sind überwiegend englisch. Englische Wörter landen deshalb öfter als Ganzes im Vokabular. Deutsche Wörter, gerade lange Zusammensetzungen wie „Kundenzufriedenheitsumfrage“, werden in mehr Stücke zerlegt.
Wie groß der Unterschied ist, haben Forscher der Universität Oxford 2023 gemessen. Sie ließen dieselben 2.000 Sätze in 200 Sprachen tokenisieren. Beim Tokenizer von GPT-4 brauchte Deutsch 1,58-mal so viele Tokens wie Englisch, beim älteren GPT-2 sogar das 2,14-Fache. Ein deutsches Modell namens GottBERT brauchte für Deutsch dagegen weniger Tokens als für Englisch. Es liegt also nicht an der Sprache, sondern am Tokenizer.
Beispiel A · Sprache
Dieselbe Produktbeschreibung, zwei Sprachen
10.000
Tokens auf Englisch
15.800
Tokens auf Deutsch
Rund 58 % mehr Kosten und Platz im Kontextfenster
Rechnung mit dem Durchschnittsfaktor 1,58 für den GPT-4-Tokenizer (Petrov u. a. 2023). Neuere Tokenizer mit größerem Vokabular dürften weniger Abstand haben, belegt ist das nicht.
Beispiel B · Modellwechsel
Derselbe Prompt auf einem neueren Claude-Modell
20.000
Tokens vorher
bis 27.000
Tokens nachher
Gleicher Preis pro Token, höhere Rechnung
Seit Claude Opus 4.7 nutzt Anthropic einen neuen Tokenizer, der denselben Text je nach Inhalt in das 1,0- bis 1,35-Fache an Tokens zerlegt.
Häufige Fehler
Fehler 1 · Die englische Faustregel auf Deutsch anwenden
„Ein Token sind etwa vier Zeichen“ gilt für Englisch. Für deutsche Texte unterschätzt du damit Kosten und Länge deutlich. Zähl lieber nach.
Fehler 2 · Token-Zahlen zwischen Modellen übertragen
Jeder Tokenizer zählt anders, auch innerhalb eines Anbieters. Anthropic rät ausdrücklich, nach einem Modellwechsel neu zu zählen, statt alte Werte für Kosten oder Kontextfenster weiterzuverwenden.
Fehler 3 · Nur auf den Preis pro Million Tokens schauen
Zwei Modelle mit gleichem Token-Preis können für denselben Text unterschiedlich viel kosten. Vergleich die Kosten deshalb an einem echten Text aus deinem Alltag, nicht an der Preisliste.
Fehler 4 · Online-Zähler für exakt halten
OpenAIs Tokenizer im Web zählt nur für OpenAI-Modelle. Selbst Anthropic nennt das Ergebnis seiner eigenen Zähl-Schnittstelle eine Schätzung. Für Budgets reicht das, für exakte Abrechnungen nicht.
So zählst du Tokens
- OpenAI: Der Tokenizer im Web zeigt, wie ein Text zerlegt wird. Entwickler nutzen die Bibliothek tiktoken.
- Anthropic: Die Token-Counting-Schnittstelle ist kostenlos und zählt mit dem Tokenizer des gewählten Claude-Modells.
- Google: Die Gemini-API hat dafür die Funktion countTokens.
- In n8n und anderen Automationen: Die Antwort der KI enthält meist die Zahl der verbrauchten Tokens. Logg sie mit, dann siehst du die echten Kosten pro Durchlauf.
Häufige Fragen
Warum kostet ein deutscher Text bei KI-Modellen mehr als ein englischer?
Weil Tokenizer vor allem mit englischen Texten trainiert werden und deutsche Wörter öfter in mehrere Stücke zerlegen. Beim GPT-4-Tokenizer brauchte Deutsch laut einer Studie von 2023 im Schnitt 1,58-mal so viele Tokens wie Englisch. Da nach Tokens abgerechnet wird, steigt der Preis entsprechend.
Wie viele Tokens hat ein deutsches Wort?
Eine feste Zahl gibt es nicht. Kurze, häufige Wörter sind oft ein Token, lange Zusammensetzungen zerfallen in mehrere. Die englische Faustregel von etwa vier Zeichen pro Token gilt für Deutsch nicht. Wer es genau wissen will, zählt mit dem Tokenizer des jeweiligen Modells.
Haben alle KI-Modelle denselben Tokenizer?
Nein. OpenAI nutzt für GPT-4 cl100k_base und für GPT-4o bis GPT-5 o200k_base, Google für Gemma ein Vokabular mit rund 256.000 Tokens. Anthropic hat mit Claude Opus 4.7 einen neuen Tokenizer eingeführt. Token-Zahlen lassen sich deshalb nicht zwischen Modellen übertragen.
Was ist Byte-Pair-Encoding?
Byte-Pair-Encoding ist das verbreitetste Verfahren, mit dem Tokenizer ihr Vokabular lernen. Es beginnt mit einzelnen Zeichen und fügt immer das häufigste benachbarte Paar zu einem neuen Token zusammen, bis die gewünschte Vokabulargröße erreicht ist.
Wird es bei einem Modellwechsel teurer, obwohl der Preis gleich bleibt?
Das kann passieren. Anthropic gibt an, dass derselbe Text ab Claude Opus 4.7 je nach Inhalt in das 1,0- bis 1,35-Fache an Tokens zerlegt wird. Bei gleichem Preis pro Token steigt die Rechnung dann. Zähl nach jedem Wechsel an echten Texten nach.


