Was ist Texterkennung?
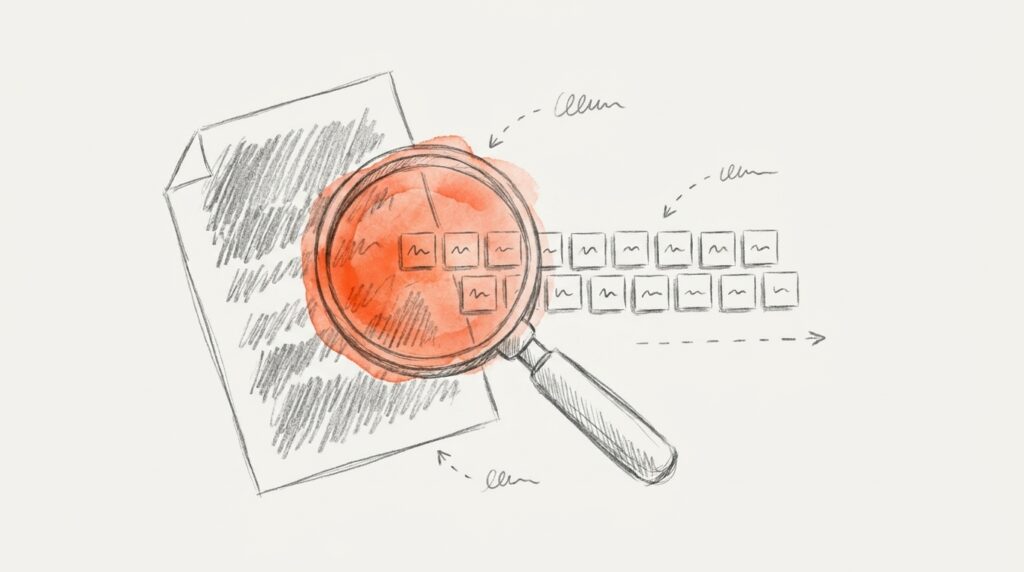
Du scannst eine Rechnung ein und willst im PDF nach dem Betrag suchen. Nichts. Für den Computer ist der Scan ein Bild aus Pixeln, kein Text. Texterkennung, englisch OCR für Optical Character Recognition, ändert das.
IBM beschreibt den Ablauf in fünf Schritten:
- Erfassen: Das Bild wird eingelesen, meist in Schwarz-Weiß umgewandelt.
- Vorbereiten: Die Software richtet schiefe Seiten gerade und entfernt Linien und Kästen.
- Zeichen erkennen: Sie vergleicht Formen mit bekannten Schriften oder sucht Merkmale wie Bögen und Kreuzungen.
- Layout erkennen: Absätze, Tabellen und Bilder werden getrennt.
- Ausgeben: Am Ende steht bearbeitbarer Text oder ein durchsuchbares PDF.
Welche Dienste gibt es?
Für kleine Firmen kommen vier Wege in Frage:
- Google Cloud Vision: zwei Funktionen — eine für Text in Fotos wie Schilder, eine für dichte Dokumente und Handschrift. Die Verarbeitung lässt sich auf die Region EU festlegen.
- AWS Textract: liest Text aus JPEG, PNG, PDF und TIFF, auf Wunsch auch Formularfelder und Tabellen.
- Azure Document Intelligence: Das Read-Modell liest gedruckten und handschriftlichen Text und macht aus einem Scan ohne Aufpreis ein durchsuchbares PDF.
- Tesseract: kostenlos und Open Source, ursprünglich von Hewlett-Packard, später von Google weiterentwickelt. Es kennt über 100 Sprachen und läuft auf deinem eigenen Rechner.
In Automationen hängst du den Dienst einfach als Schritt ein. n8n hat zum Beispiel einen eigenen Baustein für AWS Textract, alle anderen Dienste erreichst du über einen HTTP-Request.
Was kostet Texterkennung?
Erstaunlich wenig — solange du nur Text willst. AWS Textract nimmt für reinen Text 1,50 US-Dollar je 1.000 Seiten. Sollen Rechnungsfelder wie Betrag und Lieferant gleich mit ausgelesen werden, sind es 10 US-Dollar je 1.000 Seiten. Neukunden haben drei Monate lang 1.000 Seiten Text im Monat frei.
Case A · Solopreneur
Belege per Automation erfassen
300
Belege / Monat
1,50 $
je 1.000 Seiten
300 × 0,0015 $ = 0,45 $ im Monat
Reiner Text, ohne Feldzuordnung. Im Gratis-Kontingent der ersten drei Monate sogar kostenlos.
Case B · Büro
Scan-Archiv durchsuchbar machen
2.000
Seiten je PDF (Azure)
0 $
Aufpreis für Text-PDF
Ein Lauf je Ordner, Ergebnis: durchsuchbare PDFs
Die kostenlose Azure-Stufe liest nur die ersten zwei Seiten je Dokument — gut zum Testen, nicht für den Betrieb.
Der Haken bei deutschen Dokumenten
Hier stolpern viele. Bei AWS Textract erkennt die reine Texterkennung über 40 Sprachen, auch Deutsch. Formularfelder gibt es für sechs Sprachen, darunter Deutsch. Alle anderen Funktionen — auch das Auslesen von Rechnungen und die Handschrift — sind laut AWS-Dokumentation auf Englisch beschränkt.
Für deutsche Belege heißt das: reinen Text per OCR holen und die Felder in einem zweiten Schritt zuordnen. Oder einen Dienst wählen, der deutsche Rechnungen kann. Teste immer mit echten eigenen Belegen, bevor du baust.
Und was ist mit ChatGPT, Claude und Co.?
Moderne KI-Modelle können Bilder lesen und den Inhalt gleich verstehen. Claude zum Beispiel rechnet jede PDF-Seite in ein Bild um und nutzt zusätzlich den vorhandenen Text. Du bekommst in einem Schritt, was OCR und Feldzuordnung zusammen liefern: „Betrag 1.249 €, Lieferant Müller GmbH“.
Der Preis dafür: Ein Sprachmodell kann sich etwas ausdenken. Eine Studie von ByteDance-Forschern (NeurIPS 2025) zeigt, dass solche Modelle bei unscharfen Dokumenten oft nicht merken, dass sie nichts erkennen — und plausible Inhalte erfinden. Klassische OCR liest dann eher Unsinn, den du sofort siehst.
Häufige Fehler
Fehler 1 · OCR für Auslesen halten
„Die OCR liest die Rechnung aus“ — nein, sie liest Text. Die Zuordnung zu Betrag, Datum und IBAN ist ein eigener Schritt, und der kostet bei AWS fast das Siebenfache.
Fehler 2 · Text-PDFs und Bild-PDFs verwechseln
Ein PDF aus Word hat schon eine Textebene, das kannst du direkt auslesen. Ein eingescanntes PDF ist nur ein Bild. Dafür brauchst du OCR, sonst kommt im Workflow schlicht nichts an.
Fehler 3 · KI-Ergebnisse ungeprüft buchen
Wenn ein Modell Beträge oder IBAN liest, prüf sie mit Regeln: Stimmt die Prüfsumme der IBAN? Ergeben Netto plus Steuer den Brutto-Betrag? Was ein Modell nicht falsch machen darf, fängt Code ab, nicht die Hoffnung.
Fehler 4 · E-Rechnungen abfotografieren
Seit 2025 müssen Unternehmen in Deutschland E-Rechnungen wie XRechnung oder ZUGFeRD empfangen können. Die enthalten die Daten schon strukturiert. Wer die per OCR liest, macht sich unnötig Arbeit.
So setzt du es ein
- Zuerst klären: Brauchst du nur durchsuchbaren Text oder einzelne Felder?
- Zehn echte Dokumente testen, auch die schlechten — Kassenbons, Handyfotos, Faxe.
- Einen Konfidenzwert nutzen: Die Dienste geben je Wort an, wie sicher sie sind. Unter einer Schwelle geht das Dokument an einen Menschen.
- EU-Region und Vertrag prüfen, bevor Kundendaten in die Cloud gehen.
Häufige Fragen
Was ist der Unterschied zwischen OCR und IDP?
OCR macht aus einem Bild Text. Intelligent Document Processing geht weiter: Es erkennt die Dokumentart, zieht einzelne Felder heraus, prüft sie und schickt sie an Buchhaltung oder CRM. OCR ist die erste Stufe davon.
Kann OCR Handschrift lesen?
Inzwischen oft ja. Google Cloud Vision und Azure Document Intelligence lesen Handschrift im normalen Dokumenten-Modus. AWS Textract kann Handschrift laut Dokumentation nur auf Englisch.
Wie mache ich ein gescanntes PDF durchsuchbar?
Du lässt es durch eine Texterkennung laufen, die eine unsichtbare Textebene über das Bild legt. Das können Desktop-Programme, Tesseract kostenlos auf dem eigenen Rechner oder Cloud-Dienste wie Azure ohne Aufpreis.
Ist ein KI-Modell besser als klassische OCR?
Es ist flexibler, weil es Text und Bedeutung in einem Schritt liefert. Dafür kann es bei schlechten Vorlagen Inhalte erfinden und gibt keine verlässlichen Werte, wie sicher es sich ist. Für Beträge und Kontonummern brauchst du deshalb eine Prüfung per Regel.
Brauche ich mit der E-Rechnung noch OCR?
Für echte E-Rechnungen nicht, denn XRechnung und ZUGFeRD enthalten die Daten maschinenlesbar. Für Papierbelege, Kassenbons, Verträge und alte Scans bleibt OCR nötig.
Quellen
- IBM: What is optical character recognition?
- Google Cloud: Texterkennung in Bildern
- AWS: Preise für Amazon Textract
- AWS: Kontingente und Grenzen von Amazon Textract
- Microsoft Learn: Read-Modell von Document Intelligence
- Tesseract OCR auf GitHub
- Claude-Doku: PDF-Unterstützung
- He et al.: Halluzinationen bei der Dokumenten-Erkennung (NeurIPS 2025)
- IHK Berlin: Die E-Rechnung