

Was ist eine Clusteranalyse?
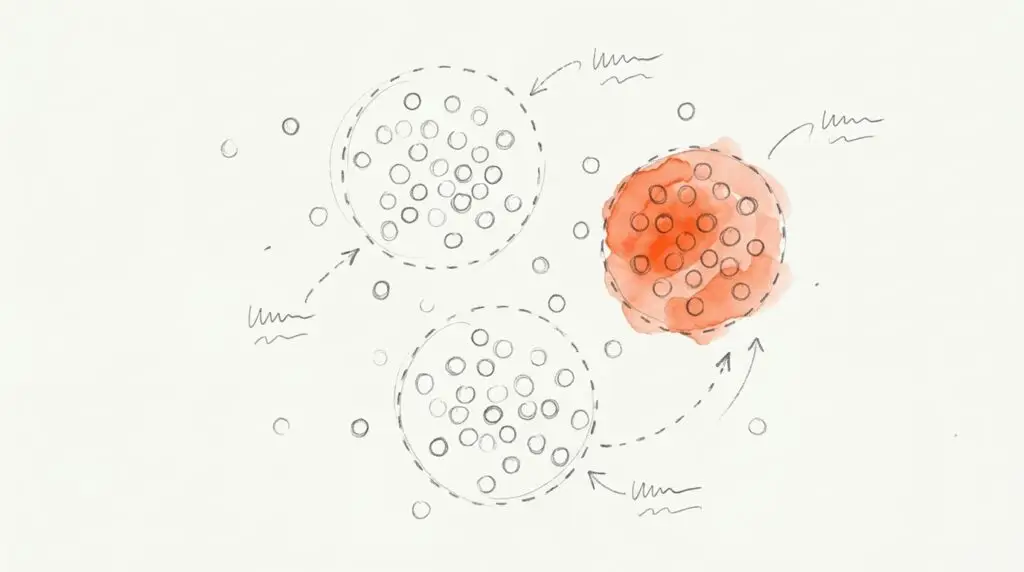
Stell dir einen Tisch voller Murmeln vor. Niemand sagt dir, nach welcher Regel du sortieren sollst. Trotzdem siehst du: Ein paar liegen eng beieinander, dort drüben auch, und ganz rechts noch eine Gruppe. Genau das macht eine Clusteranalyse mit Daten — nur in vielen Dimensionen gleichzeitig.
Das Verfahren teilt Datensätze in Gruppen, sogenannte Cluster. Innerhalb eines Clusters sind sich die Datensätze möglichst ähnlich, zwischen den Clustern möglichst verschieden. Fachlich heißt das unüberwachtes Lernen: Es gibt keine vorgegebenen Antworten, aus denen das Verfahren lernt. Es findet die Struktur selbst.
Im Marketing sind die Datensätze meist Kunden. Typische Merkmale sind die drei Werte der RFM-Analyse: wie lange der letzte Kauf her ist, wie oft jemand kauft und wie viel er ausgibt. Google nennt das Finden von Kundensegmenten ausdrücklich als Einsatzzweck seines k-Means-Verfahrens in BigQuery.
Die gängigen Verfahren
Verfahren
Gut für
k-Means
Große Datenmengen, ähnlich große, runde Gruppen
Hierarchisch
Kleinere Daten, Gruppen in Gruppen sehen
DBSCAN
Unregelmäßige Formen, Ausreißer erkennen
k-Means ist der Standard. Du gibst die Zahl der Cluster vor, das Verfahren verteilt Mittelpunkte und ordnet jeden Kunden dem nächsten zu. Die Programmbibliothek scikit-learn beschreibt es als geeignet für sehr große Datenmengen. Der Haken: Es unterstellt rundliche, gleichmäßige Gruppen. Bei langgezogenen Formen liegt es daneben.
DBSCAN sucht dagegen dichte Bereiche und lässt einzelne Punkte als Rauschen übrig. Das passt, wenn deine Daten Ausreißer haben, etwa ein paar Großkunden, die alles verzerren würden.
Wie viele Cluster sind richtig?
Das ist die Frage, an der die meisten hängen. Zwei Hilfsmittel sind üblich:
- Elbow-Methode: Du rechnest mit 2, 3, 4 … Clustern und schaust, wie stark die Streuung innerhalb der Gruppen jeweils sinkt. Wo die Kurve abknickt wie ein Ellenbogen, liegt ein guter Wert.
- Silhouettenkoeffizient: misst für jeden Punkt, wie gut er in seinen Cluster passt, von −1 bis +1. Nahe +1 heißt gut zugeordnet, um 0 heißt auf der Grenze.
In BigQuery ML wählt das Verfahren ohne Vorgabe übrigens selbst eine Zahl: den Zehner-Logarithmus der Datenzeilen. Bei 10.000 Kunden wären das vier Cluster.
Häufige Fehler
Fehler 1 · Die Daten nicht skalieren
Der Umsatz reicht von 0 bis 10.000 Euro, die Zahl der Käufe von 1 bis 20. Ohne Angleichung entscheidet der Umsatz die Abstände fast allein. Alle Merkmale müssen vorher auf eine vergleichbare Skala. BigQuery ML macht das deshalb standardmäßig automatisch.
Fehler 2 · Einem einzigen Lauf trauen
k-Means startet mit zufälligen Mittelpunkten und findet manchmal nur eine mittelmäßige Lösung. scikit-learn empfiehlt mehrere Läufe mit verschiedenen Startpunkten. Kommen jedes Mal andere Gruppen heraus, ist das Ergebnis nicht stabil.
Fehler 3 · Cluster ohne Maßnahme
„Cluster 3: mittlerer Umsatz, mittlere Frequenz“ hilft niemandem. Jede Gruppe braucht einen Namen, eine Botschaft und einen Kanal. Wenn du für zwei Cluster dasselbe tun würdest, sind es in der Praxis eins.
Fehler 4 · Clustern mit Vorhersagen verwechseln
Die Prognose-Zielgruppen in GA4, etwa „wahrscheinliche Käufer in 7 Tagen“, sind keine Clusteranalyse. Dort lernt ein Modell aus bekannten Ergebnissen. Das heißt Klassifikation, also überwachtes Lernen.
Womit du anfängst
- Python mit scikit-learn: der Standard, kostenlos, mit k-Means, DBSCAN und Silhouette eingebaut.
- R: mit den Funktionen kmeans() und hclust() ebenfalls schnell gemacht.
- BigQuery ML: k-Means per SQL, praktisch, wenn deine GA4- oder Shopdaten schon dort liegen.
- SPSS: klassisch in der Marktforschung.
- KI-Assistenten: Claude oder ChatGPT können einen CSV-Export clustern und das Ergebnis erklären. Kundendaten vorher pseudonymisieren.
Häufige Fragen
Was ist der Unterschied zwischen Clusteranalyse und Segmentierung?
Segmentierung ist das Ziel: Kunden in Gruppen für unterschiedliche Ansprache einteilen. Das geht nach festen Regeln, etwa „Umsatz über 500 €“, oder datengetrieben per Clusteranalyse. Die Clusteranalyse ist also ein Werkzeug der Segmentierung.
Wie viele Cluster sind richtig?
Es gibt keine feste Zahl. Elbow-Methode und Silhouettenkoeffizient geben Hinweise, sind sich aber nicht immer einig. Entscheidend ist, ob du für jede Gruppe etwas anderes tun würdest. Im Marketing landen viele bei drei bis sechs.
Welches Verfahren soll ich nehmen?
Für den Einstieg k-Means: schnell, bekannt, in jedem Werkzeug verfügbar. Hast du viele Ausreißer oder unregelmäßig geformte Gruppen, probier DBSCAN. Bei kleinen Datenmengen zeigt ein hierarchisches Verfahren schön, wie Gruppen zusammenhängen.
Ist Keyword-Clustering dasselbe?
Nein. Keyword-Clustering in der Suchmaschinenoptimierung gruppiert Suchbegriffe nach Suchintention und Überschneidung in den Suchergebnissen. Das Prinzip „Ähnliches zusammen“ ist verwandt, die Daten und Methoden sind andere.
Kann ich eine Clusteranalyse in Excel machen?
Ein k-Means ist in Excel nicht eingebaut. Du kannst RFM-Punkte per Formel vergeben und so regelbasiert segmentieren. Für echtes Clustering nimm Python, R, BigQuery oder einen KI-Assistenten mit Datenanalyse.


